Suomi on perinteisesti tunnettu konsensus-hakuisesta politiikastaan, jossa karkeasti yleistäen harmaan eri sävyissä vaihtelevat puolueet tekevät yhteistyötä suurin piirten saman suuntaisten tavoitteiden eteen. Mutta Suomeenkin on rantautunut viime aikoina korostunut poliittinen polarisaatio; Pekka Haavistokin sai omiltaan täyslaidallisen kun ei kategorisesti suostunut sulkemaan pois (muutenkin äärimmäisen epätodennäköistä) hallitusyhteistyötä Perussuomalaisten kanssa. Isossa maailmassa USA: ssa demokraattien ja republikaanien välinen yhteistyö on käytännössä jo mahdotonta ja maa on jakautunut kahteen vihamieliseen leiriin, jossa jopa perinteinen vihollinen Venäjä voi alkaa näyttäytymään oman maan vastapuolta parempana vaihtoehtona.
Toinen äänestysten ennalta-arvattavuutta lisäävä tekijä on puoluekuri. Puoluekuria on usein demonisoitu Suomessa, koska se sitoo kansanedustajat kädet äänestämään mahdollisesti oman omatuntonsa vastaisesti. Toisaalta se on tärkeää eduskunnan jouhevalle toiminnalle ja tavallaan äänestysten ennustettavuuden parantumisen kautta myös lisää äänestäjien kuluttajan turvaa (niin kauan kuin äänestää ensisijaisesti puoluetta eikä ehdokasta, kuten Suomen järjestelmässä tulisi tehdä). Mutta puoluekuri on myös omiaan lisäämään eduskuntaäänestys äänijakauman polarisaatiota; joko koko puolue äänestää asian puolesta tai kukaan ei äänestä.
Joskus harvoin kuitenkin eduskuntaankin päätyy sellaisia aloitteita, jotka saavat yksimielisen tai liki yksimielisen tuen. Tarkoitukseni on tutkia, että voidaanko äänestyksen lopputulosta ennustaa aloitteen otsikon perusteella. Data on haettu Eduskunnan avoimen rajapinnan kautta, rajaten kysely suurin piirtein nykyiseen hallituskauteen alkaen vuodesta 2015 (kysely tehdään äänestysId:n avulla ja kerralla saa maksimissaan 100 tulosta). Lisäksi datasta otetaan vain suomenkieliset rivit mukaan. Lopullinen data sisältää 2550 äänestystulosta. Tekstidataa ei kummemmin esikäsitellä vaan se otetaan vastaan sellaisenaan.
Lasken jokaiselle äänestystulokselle "yhdenmukaisuusindeksin" kaavalla itseisarvo(jaa-äänet - ei-äänet - 0.5*tyhjä-äänet / jaa-äänet + ei-äänet + 0.5*tyhjä-äänet). Näin saadaan nollan ja ykkösen välillä arvoja saava muuttuja, jossa lähellä ykköstä olevat arvot tarkoittavat sitä, että suurin osa kansanedustajista äänesti joko jaa tai ei ja lähellä nollaa olevat arvot taas sitä, että äänestys oli tiukka ja jakautui lähes tasan jaa- ja ei-äänien kesken. Tyhjää äänestäneet arvotetaan vain puolikkaan ei-äänen-arvoiseksi, koska ne eivät kuvasta täyttä erimielisyyttä. Poissa-olevia ei huomioida. Indeksin keskiarvo on 0,44 ja mediaani 0,37. Tämä tarkoittaa sitä, että kun yhdenmielisyys löytyy, se löytyy kunnolla.
Teen vielä binäärisen kohdemuuttujan jakamalla yli 0.5 indeksin arvon saaneet "melko yksimielisiin" ja vastaavasti sen alle jääneet "melko erimielisiin" äänestystuloksiin. Tätä binääristä muuttujaa vasten rupean sitten ennustamaan.
Kuvio 1. Kaikkien aloitteiden otsikoiden sanapilvi
Rakensin sekä nykyisen tekoälyhypen taustalla olevan seksikkään syvän neuroverkkomallin, jossa oli kolme "piilotettua tasoa" (hidden layer) sekä perinteisemmän tukivektorikoneen (vaikkakin tosiasiassa neuroverkot kehitettiin kauan ennen tukivektorikoneita). Tällä kertaa neuroverkkomalli vei pidemmän korren, päätyen eri testeissä noin 0,72 AUC: in tasolle (malli ei ole siis erityisen maaginen, mutta aivan toivotonkaan). Käyttäen 0.39 rajana yhdenmielisten-luokkaan kuulumiselle, malli löytää 200 sadasta testiaineiston yhdenmielisestä lopputuloksesta lopulta 122, mutta toisaalta ennustaa siihen väärin 97 tapausta, kokonaistarkkuuden jääden maltilliseen 0,66. Malli varmasti tarvitsisi sekä enemmän dataa, että myös varsinaisen aloitteen tekstisisällön, jotta pääsisimme aidosti hyviin tuloksiin.
Neuroverkosta emme saa mitenkään selville, että minkälaiset aloitteet sitten lopulta saavat koko eduskunnan tuen, enkä myöskään itse tehnyt sen enempää tutkivaa analytiikkaa asian selvittämiseksi. Alla on sanapilvi, kun data on rajoitettu vain yhdenmielisyys-indeksissä yli 0,8 arvon saaneisiin:
Kuvio 2. Varsin yksimieliseen päätökseen päätyneiden aloitteiden otsikoiden sanapilvi
Näyttää siis siltä, että erityisesti liikenne- ja viestintäministeriön hallinnonalaan kuuluvat tapaukset nauttivat suurta yksimielisyyttä.
Tämän aiheen parissa saisi varmasti hedelmällistä tutkimusta aikaiseksi. Vinkki innokkaalle väitöskirjan tekijälle, jolla on allekirjoittanutta enemmän aikaa.
lauantai 15. joulukuuta 2018
maanantai 24. syyskuuta 2018
Jalkapallojoukkueen syöttöverkoston merkitys menestykseen Venäjän MM-kisoissa
Jalkapallo ei jatkuvasti liikkeessä olevana pelinä ole yhtä hedelmällinen maaperä tilastotieteelle kuin Moneyballin synnyttänyt baseball. Kuitenkin tilastot ovat lajin kehityskulussa olleet jo pitkään mukana. Charles Reepin laskelmista 50-luvulla saatiin "tukea" Englannin surullisen kuuluisalle pitkän pallon taktiikalle, kun taas astetta sofistikoituneemmin jalkapallon tieteellistämistä edisti Kiovan Dynamossa 70-80-luvuilla Valeri Lobanovski. Lobanovski uskoi vahvasti systeemiteoriaan ja kollektiiviin. Jalkapallossa yksilöitä tärkeämpää on yhteydet heidän välillä. "Koko elämä on numero".
Bisnesmaailman tavoin 2010-luvulla datan hyödyntäminen jalkapallossa on lyönyt kunnolla lävitse. xG eli maaliodote on levinnyt muutamien tilastonörttien käytöstä jo televisiokommentaareihin. Jopa suomalaiset joukkueet keräävät laajalti dataa ja hyödyntävät sitä kehittäessään omaa pelaamistaan ja skoutatessaan vastustajaa.
StatsBomb, suurin jalkapalloanalytiikkaan keskittyvä sivusto, on julkaissut Venäjän MM-kisojen datan avoimella lisenssillä. Aion hyödyntää verkostoanalyysimenetelmiä datan perkaamiseen tutkiakseni Lobanovskin ajatusta joukkueista kahtena järjestelmänä, jossa avaimena on pelaajien väliset yhteydet.
Verkostoanalyysia on yksinkertaista soveltaa jalkapalloon ajattelemalla pelaajat noodeiksi ja pelaajan A syöttö pelaajalle B pelaajien A ja B väliseksi suunnatuksi linkiksi A -> B. Mitä useammin ottelun aikana A syöttää B:lle, sitä voimakkaampi on suhde A: sta B:hen (mutta ei välttämättä B: stä A:han). Tällä tavalla syntyvästä syöttöverkostosta voi laskea erilaisia tunnuslukuja. Yksi näistä on läheisyys (closeness), jossa lasketaan kuinka keskeinen kukin noodi on verkostossa mittaamalla noodin lyhin polku kuhunkin toiseen noodiin. Tämän syöttöfrekvenssillä painotetun verkoston tapauksessa tulkinta on, kuinka helposti pallo menee pelaajalta A pelaajalle B. Esimerkiksi jos A syöttää todella usein pelaajalle C ja C todella usein pelaajalle B, pallon saaminen A:lta B:lle on verrattain kivutonta. (mutta C:ltä A:lle taas vaikeaa, mutta käytän algoritmissäni sekä annettuja, että vastaanotettuja syöttöjä, jolloin syöttöketjun suunnalla ei ole väliä kahden pelaajan läheisyyttä arvioitaessa)
Esimerkiksi keskikenttäpelaajat ovat usein joukkueen pelinrakentelun dynamoja, joten on oletettavaa, että heillä on vahvat molemmin puoliset yhteydet kaikkiin muihin joukkueen pelaajiin ja täten lyhyt etäisyys jokaiseen joukkueen muuhun pelaajaan. Klassisesti hyökkääjät taas ovat voittopuolisesti vain vastaanottaneet syöttöjä, jolloin he ovat etäällä muusta joukkueesta, eikä pallo liiku heiltä esimerkiksi puolustukseen enää jouhevasti. Tosin jalkapallon evoluution nykytrendi on vahvasti universaaleja pelaajia suosiva, eikä Pippo Inzaghin kaltaiset peliin lähinnä maalin törkkäämällä osallistuvat pelaajat pelaa enää huipulla vaan myös kärjiltä odotetaan kokonaisvaltaista osallistumista niin puolustamiseen kuin pelinrakenteluun.
Oletukseni on, että syöttöverkostoltaan tiiviimpi joukkue on menestyvämpi kuin löyhempi. Eli joukkueen jokainen pelaaja on kiinteästi yhteyksissä muihin pelaajiin, pelipaikasta riippumatta. Tällöin joukkueen on helppo käyttää koko kenttää hyödykseen, sillä palloa saadaan liikutettua kivuttomasti keltä pelaajalta tahansa kelle pelaajalle tahansa. Jos taas syöttöverkosto pyörii lähinnä parin dynamon kautta muiden ollessa heikosti kytköksissä toisiinsa, on joukkue heikompi. Tällöin vastustajan on helppo prässätä pelinrakentelu pois eikä kentän tilaa käytetä optimaalisesti.
Kuvio 1. Finaalin syöttöverkostot
Yllä on esimerkiksi laskettu finaalin syöttöketjuista painotetut graafit. Kroatian syöttöverkosto näyttää silmämääräisesti tiiviimmältä ja myös läheisyys-mittari vahvistaa havainnon: Kroatian läheisyysindeksin keskiarvo on 0,33 ja Ranskan 0,4 (mitä lähempänä nollaa sen parempi), keskihajontojen ollessa 0,06 ja 0,11. Kroatian syöttelyssä siis oli koko joukkue paremmin mukana kuin Ranskalla.
Kroatia olikin ainakin omien muistikuvieni mukaan parempi joukkue aina helposti annettuun 2-1 rankkarimaaliin asti, jonka jälkeen pelin kontrolli (jos ei pallon hallinta) siirtyi Ranskalle. Kuvaavaaa on, että Ranskan syöttöverkostossa maalivahti Hugo Lloris on kiinteämmin mukana kuin Kroatian kollegansa Subasic ja hän syötti usein kärkeen Oliver Giroudille kun taas Subasicin syötöt kohdistuivat pääsääntöisesti toppariparille Lovren - Vida. Mielenkiintoisesti Ranskan keskikentän loistelias rakkikoira N'golo Kante on syöttöverkostossa sivuosassa, kun taas Kroatian trio Modric - Rakitic - Brozovic on kaiken ytimessä. Syöttöverkostosta saa sen kuvan, että Kroatia hallitsi palloa monipuolisesti, kun taas Ranska luotti yksinkertaisempiin kuvioihin ja parin pelaajan yhteistyöhön. Kroatia pitikin ottelussa pallo yli 60 prosenttisesti.
Ranska voitti finaalin kuitenkin lopulta melko vaivatta, vaikka teorian mukaan Kroatian olisi pitänyt viedä. Kuten sanottu, pallon hallinta ja pelin hallinta ovat kaksi eri asiaa. Miten teoria pärjää, kun läheisyysindeksiä tarkastellaan kaikkien 63 ottelun katsannossa?
Ottelun lopputulosta voi mallintaa sekä kategorisena (1X2), että jatkuvana maalierona (3-0 -> +3, 1-2 -> -1 jne). Päätän yksinkertaisuuden ja toisaalta voiton voimakkuuden huomioimisen vuoksi mallintaa ongelman jatkuvana muuttujana lineaarisella regressiolla. Selittävänä muuttujana on aina kahden joukkueen erotus valitussa muuttujassa, esimerkiksi jos kotijoukkue syötti ottelussa 300 kertaa ja vierasjoukkue 500 kertaa niin totalPassesDiff saa arvon -200. Läheisyysindikaattoreita laskin monia erilaisia, mutta lopuksi päädyin neljään: closenessMinDiff (erotus joukkueiden tärkeimmän pelaajan läheisyys-indikaattorissa), closenessSdDiff (erotus joukkueiden keskihajonnoissa), closenessMedianDiff (erotus mediaaneissa) sekä closesessForMinDiff (parhaiten joukkueiden syöttöverkostoihin integroituneiden hyökkääjien erotus).
Hypoteesihän oli: mitä tiiviimpi joukkue on (alhaisempi läheisyyden mediaani eli keskivertopelaajan integroituminen verkostoon ja alhaisempi keskihajonta, sitä paremmin se menestyy). Hyökkääjien integroituminen peliin on otettu mukaan, koska nykyfutiksen trendien mukaan oletusarvoisesti pelin rakenteluun osallistuvat giroudit ovat joukkueelleen hyödyllisempiä kuin voittopuolisesti maalintekoon keskittyvät kanet.
Koska alhaisemmat läheisyys-indikaattorien luvut ovat "parempia" ja ottelun lopputulos koodattu niin, että positiiviset arvot ovat kotijoukkueelle parempia, tulisi korrelaatiosuhteiden olla negatiivisia (jos kotijoukkueen läheisyyden mediaani on alhaisempi, menee arvo negatiivisen puolelle. Myös vierasjoukkueen korkeampi hajonta johtaisi kotijoukkueen kannalta toivottavaan negatiiviseen arvoon indikaattorissa)
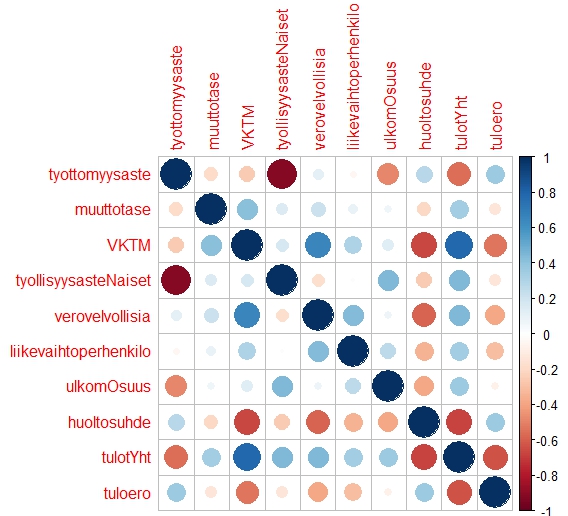
Kuvio 2. Selittävien muuttujien sekä ottelun lopputuloksen korrelaatio
Ylläolevasta korrelaatiomatriisista nähdään, että joukkueen läheisyyden mediaani sekä minimi ja hyökkääjän minimi vaikuttavat heikohkosti negatiivisesti hypoteesin mukaan. Sen sijaan keskihajonnan vaikutus tuntuisi olevan lähes nollassa. Myös joukkueiden kokonaissyöttömäärällä ei ole vaikutusta; on tärkeämpää, että koko joukkue osallistuu syöttelyyn kuin kuinka paljon lopulta syötellään.
Lineaarisesta regressiosta nähdään, että vaikutussuhteet pysyvät oletettuina (lukuunottamatta keskihajontaa, joka vaikuttaa positiivisesti ja syöttöjen yhteismäärää, joka vaikuttaa negatiivisesti), mutta pienessä aineistossa ei päästä lähellekään tilastollista merkitsevyyttä eikö merkittäviä vaikutussuhteita. Muistetaan, että läheisyyden indikaattorin skaala on 0-1, jolloin täydellisen integroituneen mediaanipelaajan suhteessa täysin irtautuneeseen mediaanipelaajaan toisi vain 0,13 maalia lisää. Jos ottelun lopputulosta (1X2) pyritään ennustamaan hyödyntäen luotuja muuttujia ja kehittyneitä koneoppimisalgoritmejä, niin ei minusta vielä betsimiljönääriä ole tulossa; xgboost-mallini toimii juuri ja juuri arvaamista paremmin.
Syöttöverkostoja yksittäistapauksina tutkimalla saa jonkinlaisen idean joukkueen pelitavasta ja potentiaalisista kipukohdista, joihin vastustajaa kannata prässätä. Jonkun verran verkostosta lasketut tunnusluvut auttavat myös selittämään ottelun lopputulosta. Mutta vain vähän. Onneksi jalkapallo pysyy lajina, jota tiede ei voi koskaan ratkaista.
Loppuun: myös StatsBombissa on selitetty xgChain-metriikalla höystettyjä syöttöverkostoja jos aihe alkoi kiinnostamaan enemmän. Lähestymistapa on erilainen kuin omani, sillä itse hyödynnän verkostoa itseään metriikan laskemiseen.
Bisnesmaailman tavoin 2010-luvulla datan hyödyntäminen jalkapallossa on lyönyt kunnolla lävitse. xG eli maaliodote on levinnyt muutamien tilastonörttien käytöstä jo televisiokommentaareihin. Jopa suomalaiset joukkueet keräävät laajalti dataa ja hyödyntävät sitä kehittäessään omaa pelaamistaan ja skoutatessaan vastustajaa.
StatsBomb, suurin jalkapalloanalytiikkaan keskittyvä sivusto, on julkaissut Venäjän MM-kisojen datan avoimella lisenssillä. Aion hyödyntää verkostoanalyysimenetelmiä datan perkaamiseen tutkiakseni Lobanovskin ajatusta joukkueista kahtena järjestelmänä, jossa avaimena on pelaajien väliset yhteydet.
Verkostoanalyysia on yksinkertaista soveltaa jalkapalloon ajattelemalla pelaajat noodeiksi ja pelaajan A syöttö pelaajalle B pelaajien A ja B väliseksi suunnatuksi linkiksi A -> B. Mitä useammin ottelun aikana A syöttää B:lle, sitä voimakkaampi on suhde A: sta B:hen (mutta ei välttämättä B: stä A:han). Tällä tavalla syntyvästä syöttöverkostosta voi laskea erilaisia tunnuslukuja. Yksi näistä on läheisyys (closeness), jossa lasketaan kuinka keskeinen kukin noodi on verkostossa mittaamalla noodin lyhin polku kuhunkin toiseen noodiin. Tämän syöttöfrekvenssillä painotetun verkoston tapauksessa tulkinta on, kuinka helposti pallo menee pelaajalta A pelaajalle B. Esimerkiksi jos A syöttää todella usein pelaajalle C ja C todella usein pelaajalle B, pallon saaminen A:lta B:lle on verrattain kivutonta. (mutta C:ltä A:lle taas vaikeaa, mutta käytän algoritmissäni sekä annettuja, että vastaanotettuja syöttöjä, jolloin syöttöketjun suunnalla ei ole väliä kahden pelaajan läheisyyttä arvioitaessa)
Esimerkiksi keskikenttäpelaajat ovat usein joukkueen pelinrakentelun dynamoja, joten on oletettavaa, että heillä on vahvat molemmin puoliset yhteydet kaikkiin muihin joukkueen pelaajiin ja täten lyhyt etäisyys jokaiseen joukkueen muuhun pelaajaan. Klassisesti hyökkääjät taas ovat voittopuolisesti vain vastaanottaneet syöttöjä, jolloin he ovat etäällä muusta joukkueesta, eikä pallo liiku heiltä esimerkiksi puolustukseen enää jouhevasti. Tosin jalkapallon evoluution nykytrendi on vahvasti universaaleja pelaajia suosiva, eikä Pippo Inzaghin kaltaiset peliin lähinnä maalin törkkäämällä osallistuvat pelaajat pelaa enää huipulla vaan myös kärjiltä odotetaan kokonaisvaltaista osallistumista niin puolustamiseen kuin pelinrakenteluun.
Oletukseni on, että syöttöverkostoltaan tiiviimpi joukkue on menestyvämpi kuin löyhempi. Eli joukkueen jokainen pelaaja on kiinteästi yhteyksissä muihin pelaajiin, pelipaikasta riippumatta. Tällöin joukkueen on helppo käyttää koko kenttää hyödykseen, sillä palloa saadaan liikutettua kivuttomasti keltä pelaajalta tahansa kelle pelaajalle tahansa. Jos taas syöttöverkosto pyörii lähinnä parin dynamon kautta muiden ollessa heikosti kytköksissä toisiinsa, on joukkue heikompi. Tällöin vastustajan on helppo prässätä pelinrakentelu pois eikä kentän tilaa käytetä optimaalisesti.
Kuvio 1. Finaalin syöttöverkostot
Yllä on esimerkiksi laskettu finaalin syöttöketjuista painotetut graafit. Kroatian syöttöverkosto näyttää silmämääräisesti tiiviimmältä ja myös läheisyys-mittari vahvistaa havainnon: Kroatian läheisyysindeksin keskiarvo on 0,33 ja Ranskan 0,4 (mitä lähempänä nollaa sen parempi), keskihajontojen ollessa 0,06 ja 0,11. Kroatian syöttelyssä siis oli koko joukkue paremmin mukana kuin Ranskalla.
Kroatia olikin ainakin omien muistikuvieni mukaan parempi joukkue aina helposti annettuun 2-1 rankkarimaaliin asti, jonka jälkeen pelin kontrolli (jos ei pallon hallinta) siirtyi Ranskalle. Kuvaavaaa on, että Ranskan syöttöverkostossa maalivahti Hugo Lloris on kiinteämmin mukana kuin Kroatian kollegansa Subasic ja hän syötti usein kärkeen Oliver Giroudille kun taas Subasicin syötöt kohdistuivat pääsääntöisesti toppariparille Lovren - Vida. Mielenkiintoisesti Ranskan keskikentän loistelias rakkikoira N'golo Kante on syöttöverkostossa sivuosassa, kun taas Kroatian trio Modric - Rakitic - Brozovic on kaiken ytimessä. Syöttöverkostosta saa sen kuvan, että Kroatia hallitsi palloa monipuolisesti, kun taas Ranska luotti yksinkertaisempiin kuvioihin ja parin pelaajan yhteistyöhön. Kroatia pitikin ottelussa pallo yli 60 prosenttisesti.
Ranska voitti finaalin kuitenkin lopulta melko vaivatta, vaikka teorian mukaan Kroatian olisi pitänyt viedä. Kuten sanottu, pallon hallinta ja pelin hallinta ovat kaksi eri asiaa. Miten teoria pärjää, kun läheisyysindeksiä tarkastellaan kaikkien 63 ottelun katsannossa?
Ottelun lopputulosta voi mallintaa sekä kategorisena (1X2), että jatkuvana maalierona (3-0 -> +3, 1-2 -> -1 jne). Päätän yksinkertaisuuden ja toisaalta voiton voimakkuuden huomioimisen vuoksi mallintaa ongelman jatkuvana muuttujana lineaarisella regressiolla. Selittävänä muuttujana on aina kahden joukkueen erotus valitussa muuttujassa, esimerkiksi jos kotijoukkue syötti ottelussa 300 kertaa ja vierasjoukkue 500 kertaa niin totalPassesDiff saa arvon -200. Läheisyysindikaattoreita laskin monia erilaisia, mutta lopuksi päädyin neljään: closenessMinDiff (erotus joukkueiden tärkeimmän pelaajan läheisyys-indikaattorissa), closenessSdDiff (erotus joukkueiden keskihajonnoissa), closenessMedianDiff (erotus mediaaneissa) sekä closesessForMinDiff (parhaiten joukkueiden syöttöverkostoihin integroituneiden hyökkääjien erotus).
Hypoteesihän oli: mitä tiiviimpi joukkue on (alhaisempi läheisyyden mediaani eli keskivertopelaajan integroituminen verkostoon ja alhaisempi keskihajonta, sitä paremmin se menestyy). Hyökkääjien integroituminen peliin on otettu mukaan, koska nykyfutiksen trendien mukaan oletusarvoisesti pelin rakenteluun osallistuvat giroudit ovat joukkueelleen hyödyllisempiä kuin voittopuolisesti maalintekoon keskittyvät kanet.
Koska alhaisemmat läheisyys-indikaattorien luvut ovat "parempia" ja ottelun lopputulos koodattu niin, että positiiviset arvot ovat kotijoukkueelle parempia, tulisi korrelaatiosuhteiden olla negatiivisia (jos kotijoukkueen läheisyyden mediaani on alhaisempi, menee arvo negatiivisen puolelle. Myös vierasjoukkueen korkeampi hajonta johtaisi kotijoukkueen kannalta toivottavaan negatiiviseen arvoon indikaattorissa)
Kuvio 2. Selittävien muuttujien sekä ottelun lopputuloksen korrelaatio
Ylläolevasta korrelaatiomatriisista nähdään, että joukkueen läheisyyden mediaani sekä minimi ja hyökkääjän minimi vaikuttavat heikohkosti negatiivisesti hypoteesin mukaan. Sen sijaan keskihajonnan vaikutus tuntuisi olevan lähes nollassa. Myös joukkueiden kokonaissyöttömäärällä ei ole vaikutusta; on tärkeämpää, että koko joukkue osallistuu syöttelyyn kuin kuinka paljon lopulta syötellään.
Lineaarisesta regressiosta nähdään, että vaikutussuhteet pysyvät oletettuina (lukuunottamatta keskihajontaa, joka vaikuttaa positiivisesti ja syöttöjen yhteismäärää, joka vaikuttaa negatiivisesti), mutta pienessä aineistossa ei päästä lähellekään tilastollista merkitsevyyttä eikö merkittäviä vaikutussuhteita. Muistetaan, että läheisyyden indikaattorin skaala on 0-1, jolloin täydellisen integroituneen mediaanipelaajan suhteessa täysin irtautuneeseen mediaanipelaajaan toisi vain 0,13 maalia lisää. Jos ottelun lopputulosta (1X2) pyritään ennustamaan hyödyntäen luotuja muuttujia ja kehittyneitä koneoppimisalgoritmejä, niin ei minusta vielä betsimiljönääriä ole tulossa; xgboost-mallini toimii juuri ja juuri arvaamista paremmin.
Syöttöverkostoja yksittäistapauksina tutkimalla saa jonkinlaisen idean joukkueen pelitavasta ja potentiaalisista kipukohdista, joihin vastustajaa kannata prässätä. Jonkun verran verkostosta lasketut tunnusluvut auttavat myös selittämään ottelun lopputulosta. Mutta vain vähän. Onneksi jalkapallo pysyy lajina, jota tiede ei voi koskaan ratkaista.
Loppuun: myös StatsBombissa on selitetty xgChain-metriikalla höystettyjä syöttöverkostoja jos aihe alkoi kiinnostamaan enemmän. Lähestymistapa on erilainen kuin omani, sillä itse hyödynnän verkostoa itseään metriikan laskemiseen.
keskiviikko 21. maaliskuuta 2018
Millainen kansalaiskampanja, sellainen yhteiskunta? Digitaalinen aktivismi ja poliittinen järjestelmä
Suomessa on viime aikoina käyty keskustelua kansalaisaloitteesta, kun eduskuntakäsittelyyn etenevien kansalaisaloitteiden lukumäärä alkaa hiljalleen kasvamaan, viimeisimpänä perintöverosta luopumista ajava aloite. Kansalaisaloitteet ja kansalaisaktivismi on muutenkin tutkimusten mukaan nuorempien sukupolvien preferoima tapa vaikuttaa ympäröivään yhteiskuntaan. Äänestäminen ja eritoten poliittiset puolueet menettävät suosiotaan. Suurten ideologisten narratiivien sijaan ihmisiä ajaa liikkeelle hyvin spesifit ja tarkkarajaiset, konkreettisia tavoitteita ajavat kampanjat.
Netti on tuonut myös aivan uusia vaikuttamisen mahdollisuuksia. Nykyajan vaikuttamisen mahdollisuudet eivät rajoitu mielenosoituksessa marssimiseen tai itsensä kahlitsemiseen kiinni puuhun.
Suomen kaltaisessa demokratiassa kansalaisaktivismi on kuitenkin vain yksi tapa muiden joukossa vaikuttaa yhteiskuntaan. Hauraissa demokratioissa tai suoranaisissa diktatuureissa se voi olla ainoa; ja silloinkin hengenvaarallinen. Tämän luulisi vaikuttavan merkittävästi myös kansalaisaktivismin muotoihin. On varmasti eri asia koittaa saada tasa-arvoinen avioliittolaki lävitse Suomessa kuin Ugandassa. Tutkitaan siis Digital Activism-tutkimusprojektin datasettiä!
Datassa on tutkittu reilua 400 digitaalista kampanjaa, joita kuvaillaan yli 20 muuttujalla. Kampanjan sijaintivaltiot luokitellaan täysiksi, siirtyviksi, vaillinaisiksi demokratioiksi sekä diktatuureiksi. Tämän analyysin tarpeisiin luokittelin muut kuin Suomen kaltaiset kypsät demokratiat samaan ei-demokratioiden luokkaan. Datan havainnoista 165 sijoittuu täyteen demokratiaan ja 241 muuhun valtioon. Muuttujiksi valitsin seuraavat kyllä/ei-muuttujat: käytetäänkö kampanjassa väkivaltaa, videoita, tekstiviestejä tai hakkerointia sekä onko sillä omaa nettisivua, foorumia, mikroblogia, blogia, sosiaalisen median tunnuksia tai adressia.
Ylläolevista muuttujista haktivismi eli hakkeroinnin hyödyntäminen ja väkivallan hyödyntäminen ovat varsin harvoin hyödynnettyjä keinoja. Väkivaltaan sortui 14 kampanjaa, hakkerointiin 9. Myös tekstiviestien ja omien keskustelufoorumien hyödyntäminen oli hyvin vähäistä. Muita keinoja hyödynnettiin sitten enemmän. Kaikista yleisintä oli blogin ylläpitäminen; sellainen löytyi yli puolelta eli 213 tapaukselta.
Miten nämä valitut muuttujat sitten suhtautuvat kampanjan yhteiskunnan demokraattisuuteen? Hyödynnetään logistista regressiomallinnusta asian selvittämiseen. Alla mallin ristitulosuhteet (referenssiluokkana demokratia ja muuttujissa aina "ei käytössä".)
VIOL 2.737586
SITE 0.332152 ***
FORUM 0.345003
EPET 0.292376 ***
SOCNET 0.935437
MICBLOG 1.596549 **
BLOG 1.045787
VIDEO 0.954749
SMS 1.740650
HACK 2.180810
Pienessä aineistosssa vain kolme muuttujaa yltää tilastolliseen merkitsevyyteen. Demokraattisissa valtioissa hyödynnetään merkittävästi enemmän adresseja sekä omia nettisivuja. Adressi onkin selkeästi työkalu, joka on useissa ei-demokraattisissa valtioissa kielletty. Myöskään harva epävarmassa poliittisessa ympäristössä toimiva varmaan haluaa lisätä omaa nimeään yhtään mihinkään aloitteeseen, jonka kohtalosta ja hallituksen suhtautumisesta siihen ei ole varma, ihan oman turvallisuutensa vuoksi.
Nettisivut ovat internetin mittapuulla varsin stabiili ja virallinen työkalu. Epävarmassa tilanteessa, jossa kampanja elää jatkuvasti, nettisivu ei siten liene optimaalinen väline vaikuttamiseen. Nettisivun olemassaolo lisääkin kampanjan todennäköisyyden sijaita demokraattisessa valtiossa noin kolminkertaiseksi. Nettisivulla ei ole des takeita pysyä kauaa pystyssä Kiinan kaltaisia nettiään ankarasti sensuroivissa maissa. Kypsissä demokratioissa, joissa kampanjat voivat luottaa pysyvyyteen ja mahdollisuuteen vaikuttaa virallisia väyliä pitkin, nettisivu on paljon toimivampi. Sama pätee keskustelufoorumeihin, joita oli tosin käytössä niin harvassa kampanjassa, ettei sen kerroin ole tilastollisesti merkitsevä.
Mikroblogit taas ovat epädemokraattisten maiden kampanjoiden välineistöä, mikroblogin käytön lisätessä todennäköisyyden kampanjan kotivaltion epädemokraattiselle järjestelmälle noin 1,6-kertaiseksi. Ne ovat nopea ja joustava väline, jotka mahdollistavat nopean reagoinnin ja tiedonvaihdon, mutta myös sen, ettei kampanja hirttäydy yhteen, viralliseen blogikanavaan. Tekstiviestit ovat myös epädemokraattisten maiden käytössä useammin, mutta niin vähissä määrin, ettei aineistosta voi tehdä suurempia johtopäätöksiä.
Hakkerointi ja väkivalta ovat vähän käytettyjä metodeja, mutta spesifisti epädemokraattisten valtioiden kampanjoiden arsenaalissa, yli kaksinkertaisella todennäköisyydellä demokraattisiin maihin nähden. Blogi, sosiaalisen median tunnukset sekä videoiden käyttö ovat suurin piirtein yhtäläisesti käytössä sekä demokraattisten että epädemokraattisten valtioiden kampanjoissa.
Kokeilin vielä lopuksi huvikseni kokeilla, että voidaanko kampanjan kotivaltion poliittinen järjestelmä ennustaa yllämainittujen muuttujien avulla. Jaoin aineiston kahteen osaan, joista mallin sovitin 80 % aineistosta ja opitulla mallilla ennustin jäljellejäävää 20 prosenttia. Mallina kokeilin sekä random forestia sekä support vector machinea. Mallien tulokset heittelivät aika paljon aineiston pienen koon vuoksi, mutta kokonaistarkkuus heilui noin 56 ja 68 prosentin välissä. Alla on parhaan saadun SVM-mallin virhematriisi.
[[37, 12],
[14, 19]]
Malli ennusti kokonaisuudessaan reilu 68 % tapauksista oikein, virheiden jakautuessa melko tasaisesti vääriin positiivisiin ja vääriin negatiivisiin. Tällä kertaa malli on siis eroteltavissa helposti taikuudesta, mutta pienellä opetusaineistolla ei mahdottomiin pystykään.
Netti on tuonut myös aivan uusia vaikuttamisen mahdollisuuksia. Nykyajan vaikuttamisen mahdollisuudet eivät rajoitu mielenosoituksessa marssimiseen tai itsensä kahlitsemiseen kiinni puuhun.
Suomen kaltaisessa demokratiassa kansalaisaktivismi on kuitenkin vain yksi tapa muiden joukossa vaikuttaa yhteiskuntaan. Hauraissa demokratioissa tai suoranaisissa diktatuureissa se voi olla ainoa; ja silloinkin hengenvaarallinen. Tämän luulisi vaikuttavan merkittävästi myös kansalaisaktivismin muotoihin. On varmasti eri asia koittaa saada tasa-arvoinen avioliittolaki lävitse Suomessa kuin Ugandassa. Tutkitaan siis Digital Activism-tutkimusprojektin datasettiä!
Datassa on tutkittu reilua 400 digitaalista kampanjaa, joita kuvaillaan yli 20 muuttujalla. Kampanjan sijaintivaltiot luokitellaan täysiksi, siirtyviksi, vaillinaisiksi demokratioiksi sekä diktatuureiksi. Tämän analyysin tarpeisiin luokittelin muut kuin Suomen kaltaiset kypsät demokratiat samaan ei-demokratioiden luokkaan. Datan havainnoista 165 sijoittuu täyteen demokratiaan ja 241 muuhun valtioon. Muuttujiksi valitsin seuraavat kyllä/ei-muuttujat: käytetäänkö kampanjassa väkivaltaa, videoita, tekstiviestejä tai hakkerointia sekä onko sillä omaa nettisivua, foorumia, mikroblogia, blogia, sosiaalisen median tunnuksia tai adressia.
Ylläolevista muuttujista haktivismi eli hakkeroinnin hyödyntäminen ja väkivallan hyödyntäminen ovat varsin harvoin hyödynnettyjä keinoja. Väkivaltaan sortui 14 kampanjaa, hakkerointiin 9. Myös tekstiviestien ja omien keskustelufoorumien hyödyntäminen oli hyvin vähäistä. Muita keinoja hyödynnettiin sitten enemmän. Kaikista yleisintä oli blogin ylläpitäminen; sellainen löytyi yli puolelta eli 213 tapaukselta.
Miten nämä valitut muuttujat sitten suhtautuvat kampanjan yhteiskunnan demokraattisuuteen? Hyödynnetään logistista regressiomallinnusta asian selvittämiseen. Alla mallin ristitulosuhteet (referenssiluokkana demokratia ja muuttujissa aina "ei käytössä".)
VIOL 2.737586
SITE 0.332152 ***
FORUM 0.345003
EPET 0.292376 ***
SOCNET 0.935437
MICBLOG 1.596549 **
BLOG 1.045787
VIDEO 0.954749
SMS 1.740650
HACK 2.180810
Pienessä aineistosssa vain kolme muuttujaa yltää tilastolliseen merkitsevyyteen. Demokraattisissa valtioissa hyödynnetään merkittävästi enemmän adresseja sekä omia nettisivuja. Adressi onkin selkeästi työkalu, joka on useissa ei-demokraattisissa valtioissa kielletty. Myöskään harva epävarmassa poliittisessa ympäristössä toimiva varmaan haluaa lisätä omaa nimeään yhtään mihinkään aloitteeseen, jonka kohtalosta ja hallituksen suhtautumisesta siihen ei ole varma, ihan oman turvallisuutensa vuoksi.
Nettisivut ovat internetin mittapuulla varsin stabiili ja virallinen työkalu. Epävarmassa tilanteessa, jossa kampanja elää jatkuvasti, nettisivu ei siten liene optimaalinen väline vaikuttamiseen. Nettisivun olemassaolo lisääkin kampanjan todennäköisyyden sijaita demokraattisessa valtiossa noin kolminkertaiseksi. Nettisivulla ei ole des takeita pysyä kauaa pystyssä Kiinan kaltaisia nettiään ankarasti sensuroivissa maissa. Kypsissä demokratioissa, joissa kampanjat voivat luottaa pysyvyyteen ja mahdollisuuteen vaikuttaa virallisia väyliä pitkin, nettisivu on paljon toimivampi. Sama pätee keskustelufoorumeihin, joita oli tosin käytössä niin harvassa kampanjassa, ettei sen kerroin ole tilastollisesti merkitsevä.
Mikroblogit taas ovat epädemokraattisten maiden kampanjoiden välineistöä, mikroblogin käytön lisätessä todennäköisyyden kampanjan kotivaltion epädemokraattiselle järjestelmälle noin 1,6-kertaiseksi. Ne ovat nopea ja joustava väline, jotka mahdollistavat nopean reagoinnin ja tiedonvaihdon, mutta myös sen, ettei kampanja hirttäydy yhteen, viralliseen blogikanavaan. Tekstiviestit ovat myös epädemokraattisten maiden käytössä useammin, mutta niin vähissä määrin, ettei aineistosta voi tehdä suurempia johtopäätöksiä.
Hakkerointi ja väkivalta ovat vähän käytettyjä metodeja, mutta spesifisti epädemokraattisten valtioiden kampanjoiden arsenaalissa, yli kaksinkertaisella todennäköisyydellä demokraattisiin maihin nähden. Blogi, sosiaalisen median tunnukset sekä videoiden käyttö ovat suurin piirtein yhtäläisesti käytössä sekä demokraattisten että epädemokraattisten valtioiden kampanjoissa.
Kokeilin vielä lopuksi huvikseni kokeilla, että voidaanko kampanjan kotivaltion poliittinen järjestelmä ennustaa yllämainittujen muuttujien avulla. Jaoin aineiston kahteen osaan, joista mallin sovitin 80 % aineistosta ja opitulla mallilla ennustin jäljellejäävää 20 prosenttia. Mallina kokeilin sekä random forestia sekä support vector machinea. Mallien tulokset heittelivät aika paljon aineiston pienen koon vuoksi, mutta kokonaistarkkuus heilui noin 56 ja 68 prosentin välissä. Alla on parhaan saadun SVM-mallin virhematriisi.
[[37, 12],
[14, 19]]
Malli ennusti kokonaisuudessaan reilu 68 % tapauksista oikein, virheiden jakautuessa melko tasaisesti vääriin positiivisiin ja vääriin negatiivisiin. Tällä kertaa malli on siis eroteltavissa helposti taikuudesta, mutta pienellä opetusaineistolla ei mahdottomiin pystykään.
tiistai 30. tammikuuta 2018
Suomen presidentinvaalit Twitter-maailmassa
Suomen presidentinvaaleja 2018 voidaan monesta syystä pitää länsimaisten demokratioiden katsantokannassakin poikkeuksellisina. Sauli Niinistö vei tittelin historiallisesti jo ensimmäisellä kierroksella yli 60 prosentin kannatuksella eikä hänen edes tarvinnut hikoilla. Perinteisten valtapuolueiden SDP:n ja Keskustan ehdokkaat saivat hieman korkeamman kannatuksen kuin oman kansanliikkeensä perustanut politiikan ikiliikkuja Paavo Väyrynen; ja tämä ei johdu siitä, että Paavokaan olisi päässyt edes lähelle kaksinumeroisia lukuja. Vaalien voittaja ei tullut kenellekään yllätyksenä, mutta Saulin ylivoima oli odotettuakin murskaavampi.
Ennen vaalien tulosiltaa jännitystä haettiin lähinnä teemoista "tuleeko toinen kierros", "voittaako Väyrynen Vanhasen" ja "voiko Väyrynen haastaa Haaviston toisesta sijasta?". Miten Suomen Twitter-kansa innostui spekuloimaan vaaleja kun voittajan sijaan jännitettiin lähinnä jämäsijoja ja hyvän tsempparin palkintoja?
Laitoin sunnuntaina koodini keräämään kaikki twiitit, joissa mainittiin muutamia vaaleihin liittyviä hashtageja, kuten "#presidentinvaalit2018. Twiittien kalastelu alkoi hieman ennen kolmea iltapäivällä ja päättyi yhdentoista aikaan illalla. Saaliikseni sain vajaa 9000 twiittiä, joista uusia (eli ei-retweettejä) oli 6389. Katsotaan seuraavaksi nopeasti mitä haaviini tarttui (ja pidetään mielessä, että koko Suomen presidentinvaaleja koskeva vaalipäivän Twitter-keskustelu ei varmasti sisälly aineistooni hakusanojen rajallisuuden vuoksi)
Ennen vaalien tulosiltaa jännitystä haettiin lähinnä teemoista "tuleeko toinen kierros", "voittaako Väyrynen Vanhasen" ja "voiko Väyrynen haastaa Haaviston toisesta sijasta?". Miten Suomen Twitter-kansa innostui spekuloimaan vaaleja kun voittajan sijaan jännitettiin lähinnä jämäsijoja ja hyvän tsempparin palkintoja?
Laitoin sunnuntaina koodini keräämään kaikki twiitit, joissa mainittiin muutamia vaaleihin liittyviä hashtageja, kuten "#presidentinvaalit2018. Twiittien kalastelu alkoi hieman ennen kolmea iltapäivällä ja päättyi yhdentoista aikaan illalla. Saaliikseni sain vajaa 9000 twiittiä, joista uusia (eli ei-retweettejä) oli 6389. Katsotaan seuraavaksi nopeasti mitä haaviini tarttui (ja pidetään mielessä, että koko Suomen presidentinvaaleja koskeva vaalipäivän Twitter-keskustelu ei varmasti sisälly aineistooni hakusanojen rajallisuuden vuoksi)
Kuvio 1. Twiittien lähetysajankohta
Ylläolevasta kuviosta nähdään, että twiittejä tuli päivän mittaan varsin tasaisesti kunnes Ylen ja Maikkarin vaalilähetykset alkoivat 19:30. Kello 20.00 paljastettiin ennakkoäänien tulokset, mikä aiheutti suuren piikin twiittien määrään. Tämän jälkeen twiittien määrä pysyi korkeahkolla tasolla, mutta laski koko ajan. 21.00 aikaan julkaistu Ylen ennuste näkyy vielä yhtenä piikkinä. Kellon lähetessä 23.00 ei twiittejä enää kauhean aktiivisesti haaviini kertynyt.
Mitä twiitit sitten käsittelivät?
Kuvio 2. Twiittien sanapilvi
Sanapilvi ei tuota yllätyksiä yleisimmissä sanoissa. Kiinnostavinta on ehkä nähdä, ketkä ehdokkaat siinä esiintyvät: Sauli Niinistö, Laura Huhtasaari, Paavo Väyrynen ja Pekka Haavisto. Haatainen ja Kyllönen esiintyvät vähemmän, mutta Keskustan Matti-raukkaa ei näy missään.
Jos sanapilvi ei kauheasti kiinnostavaa informaatiota meille tarjoa niin matemaattisesti edistyksellisempi topic model-mallikaan ei hirveästi aukaise twiittien sisältöä. Kokeilin ajaa mallin usealla eri topicien määrällä, mutta kovin informatiivisia aihealueita ei twiiteistä onnistuttu löytämään. Alla nähdään kolmen (alle 10 kertaa esiintyvät sanat poistettu) sekä viiden (tf-idf-muunnoksella) aihealueen mallin tulokset aihealueisiin voimakkaimmin latautuneiden sanojen osalta.
Sanapilvi ei tuota yllätyksiä yleisimmissä sanoissa. Kiinnostavinta on ehkä nähdä, ketkä ehdokkaat siinä esiintyvät: Sauli Niinistö, Laura Huhtasaari, Paavo Väyrynen ja Pekka Haavisto. Haatainen ja Kyllönen esiintyvät vähemmän, mutta Keskustan Matti-raukkaa ei näy missään.
Jos sanapilvi ei kauheasti kiinnostavaa informaatiota meille tarjoa niin matemaattisesti edistyksellisempi topic model-mallikaan ei hirveästi aukaise twiittien sisältöä. Kokeilin ajaa mallin usealla eri topicien määrällä, mutta kovin informatiivisia aihealueita ei twiiteistä onnistuttu löytämään. Alla nähdään kolmen (alle 10 kertaa esiintyvät sanat poistettu) sekä viiden (tf-idf-muunnoksella) aihealueen mallin tulokset aihealueisiin voimakkaimmin latautuneiden sanojen osalta.
Topic 1 Topic 2 Topic 3 [1,] "huhtasaari" "niinistö" "niinistö" [2,] "vaalit" "sitten" "väyrynen" [3,] "niinistö" "uusi" "vaalit" [4,] "the" "jo" "sauli" [5,] "kaikki" "voi" "niinistön" [6,] "presidentti" "onnea" "niinisto" [7,] "sauli" "sauli" "presidentinvaalit" [8,] "kyllä" "hyvä" "vielä" [9,] "presidentinvaalit" "tule" "tänään" [10,] "väyrynen" "kannatus" "paavo"
Toinen aihealue sisältänee onnittelu viestejä Saulille. Aihealueet 1 ja 3 sisältävät yleisempää keskustelua vaaleista ja sisältävät myös mainintoja kilpakumppaneista, Väyrysestä ja Huhtasaaresta. Mitään mielenkiintoista ei tästä kuitenkaan irtoa.
Topic 1 Topic 2 Topic 3 Topic 4 Topic 5 [1,] "vaalit" "niinistö" "の" "the" "niinistö" [2,] "uusi" "sauli" "hienoa" "of" "prosenttia" [3,] "normaali" "näyttää" "が" "vote" "toinen" [4,] "väyrynen" "äänesti" "siinä" "in" "päästä" [5,] "laura" "selvä" "voittaja" "niinistö" "onnea" [6,] "huhtasaari" "onneksi" "を" "elect" "kekkonen" [7,] "äänestin" "jo" "フィンランド" "finland" "sauli" [8,] "voi" "vaalit" "tuntuu" "for" "vaalit" [9,] "suomessa" "presidentinvaalit" "niinistö" "and" "presidentti" [10,] "paavo" "presidentti" "niinistön" "is" "niinisto"
Tf-idf-muunnoksen jälkeen aihepiireihin ilmestyi Huhtasaaren illan aikana tutuksi tullutta "uutta normaalia" käsittelevä aihealue, joka sisältää myös Paavon. Aihepiiri 2 sisältää keskustelua Niinistön selvästä voitosta, aihepiiri 5 taas rinnastanee Saulia Suomen historian pitkäaikaisimpaan presidenttiin Urho Kekkoseen. Aihepiiri 4 sisältää kansainväliset twiitit Suomen vaaleista, aihepiiri 3 taas on aikamoinen jämäluokka.
Aineistoa olisi voinut yrittää muokata ja korjata rankemmalla kädellä ennen LDA-mallin ajamista, niin ehkä twiittailun luonne ja eri diskurssit olisivat selvinneet helpommin. Nyt näistä ei saada mitään kummempaa irti.
Tein aineistolle myös kömpelön sanalista-pohjaisen sentimenttianalyysini, jota olen hyödyntänyt aikaisemmissakin blogipostauksissa. Algoritmini luokitteli 3500 twiittiä neutraaliksi, 1500 positiiviseksi ja 1300 negatiiviseksi. Suuria tunteita twiiteissä ei siis ilmeisesti pääpiirteittäin esiintynyt.
neg neut pos 1310 3541 1538 |
| Lopuksi tein verkostomallin saadakseni selville, että käytiinkö vaalien yhteydessä vuorovaikutteista keskustelua,
vai oliko kyseessä ennemminkin yksittäisten twiittajien arviot ja julistukset, joihin muut eivät reagoineet. |
Kuvio 3. Verkostomalli kaikille twiittaajille
Ja, tuskin yllätyksenä, pientä ristiintwiittailevaan ydinjoukkoa lukuunottamatta twitter-massat kävivät Väyrysmäistä "Me, myself and I"-dialogia itsensä kanssa kohdistamatta viestejä kenellekään toiselle. Tylsähköt vaalit eivät siis luoneet kovin vuorovaikutteista keskustelua. Tässä on tosin huomioitava, että hakusanojeni rajallisuudesta johtuen olen voinut hyvin kaapata twiitin, jossa ei mainita ketään, mutta missata siihen tulleen vastauksen.
Kuvio 4. Verkostomalli twiittaajista, jotka kohdistivat viestin toiselle
Jotta keskustelun luonnetta voi tutkia tarkemmin otan mukaan verkostomalliin vain ne tapaukset, jotka ovat joko twiitanneet toiselle henkilölle tai ovat twiitin kohteena. Kuviossa siniset viivat tarkoittavat positiiviseksi luokiteltuja twiittejä, punaiset negatiivisia ja harmaat neutraaleja. Kuviosta nähdään verkostossa muutamia isompia keskittymiä, joiden ympärillä valtaosa interaktiivisesta twiittailusta käydään. Ulkokehällä on lisäksi paljon 2-4 twiittaajaan pienverkostoja, jotka eivät ole yhteydessä ytimeen.
Kun katsotaan ne henkilöt, joilla on eniten yhteyksiä, yllätyksenä ei tule seuraava lista:
Jotta keskustelun luonnetta voi tutkia tarkemmin otan mukaan verkostomalliin vain ne tapaukset, jotka ovat joko twiitanneet toiselle henkilölle tai ovat twiitin kohteena. Kuviossa siniset viivat tarkoittavat positiiviseksi luokiteltuja twiittejä, punaiset negatiivisia ja harmaat neutraaleja. Kuviosta nähdään verkostossa muutamia isompia keskittymiä, joiden ympärillä valtaosa interaktiivisesta twiittailusta käydään. Ulkokehällä on lisäksi paljon 2-4 twiittaajaan pienverkostoja, jotka eivät ole yhteydessä ytimeen.
Kun katsotaan ne henkilöt, joilla on eniten yhteyksiä, yllätyksenä ei tule seuraava lista:
[1] "niinisto" "niinisto2018" "LauraHuhtasaari" "Haavisto""YleTV1" "kokokansanpaavo" "yleuutiset" [8] "Yleisradio" "VanhanenMatti" "GreenThaifood""TuulaHaatainen""antti_koo" "StarckTii" "hsfi" [15] "LazyTwitTwat"
Niinistö, Huhtasaari, Haavisto ja Väyrynen ovat isoja keskittymiä. Haatainen ja Vanhanen mahtuvat mukaan myös mediatalojen ja muutaman aktiivitwiittaajan sekaan. Verkoston isoimman keskittymän keskipiste on Sauli Niinistö ja kuten kuviosta nähdään, hänelle twiitattiin ensisijaisesti positiivisia onnitteluviestejä.
Siispä verkoston ydinkin antaa turhan ruuhuisen kuvan vuorovaikutteisesta debatista, kun tosiasiassa ehdokkaiden ja mediatalojen luomat keskipisteet ovat pääsyynä twiittaajien välisille yhteyksille.
Kokonaisuutena voitaneen tiivistää, että tylsät vaalit, tylsä keskustelu. Siksipä päätin rikastaa keskustelua itse tekemällä twitter-botin, joka apinoi muiden mielipiteet ja luo niistä uusia helmiä.
lauantai 13. tammikuuta 2018
Deittailun maailma - yksi tavoite, kaksi todellisuutta?
Satuin törmäämään mielenkiintoiseen datasettiin, joka sisältää dataa Speed Dating - tapahtumista Yhdysvalloista vuosilta 2002-2004. Tinder ja muut sovellukset ovat muovanneet deittailun kenttää noista vuosista, mutta oletettavasti miehet ja naiset suhtautuvat unelmien prinssinsä/prinsessansa ominaisuuksiin ja omaan viehättävyyteensä edelleen suurin piirtein samalla tavoin.
Datasettini on varsin massiivinen tarjolla olevien muuttujien suhteen, joten keskityn tässä vain nopeasti muutamaan huomioon; kuinka miehet/naiset suhtautuvat etukäteen sokkotreffiensä laatuun, kuinka monen he uskovat olevan kiinnostuneen heistä ja mitkä ominaisuudet vaikuttavat siihen, että vastapuoli sanoo "kyllä" jatkotapaamiselle.
Yleisenä huomiona olen siirtynyt R-kielestä Pythoniin, koska töissä saan näperrellä R:n parissa nykyään aivan tarpeeksi. Blogi siirtyy siis tavallaan taas aivan alkuaikoihin, kun koitan opetella uutta ohjelmointikieltä ja motivoida itseäni blogin kirjoittamisella. Ehkä tämä blogi tulee kielen muutoksen seurauksena aktivoitumaan. Ehkä ei. Ainakin analyysieni tekninen toteutustaso ottaa takapakkia.
Mutta aloitetaan pureutuminen deittailun maailmaan!
Naisia kritisoidaan nykyään paljon siitä, että he ovat niin nirsoja ja asettavat miehille korkeat kriteerit. Tunnetusti Tinderissä naiset "swaippaavat vasemmalle" moninkertaisella todennäköisyydellä suhteessa miehiin. Perinteisemmillä nettideittailusivustoilla naiset hukkuvat miesten yhteydenottoihin, mutta miehet saavat naisilta yhteydenoton paljon harvemmin (Christian Rudderin Dataclysm-kirja sisältää paljon mielenkiintoista dataa kirjoittajan perustamalta OKCupid-sivustolta, voin suositella tutustumaan). Miten nämä nettideittailussa havaitut toimintamallit jalkautuvat speed dating-maailmaan?
Ylläolevasta kuviosta nähdään naisten ja miesten odotus tyytyväisyyteen tilaisuudessa tapaamiaan ihmisiä kohtaan, skaalalla 0-10, jossa 10 = täysin tyytyväinen. Histogrammista nähdään, että miesten odotukset ovat keskimäärin korkeammat kuin naisten. Naisten jakauma on selvästi enemmän vasemmalle kallellaan kuin miesten. Miesten keskiarvo tyytyväisyydelleen onkin 5,85, naisten 5,18. Ero on yli puoli "tyytyväisyysyksikköä". Se ei ole massiivinen, kuten Tinderissä ja OKCupidissa havaitut erot käyttäytymisessä, mutta selkeästi naisilla on lähtökohtaisesti skeptisempi asenne potentiaalisia miehiä kohtaan kuin miehillä vielä tapaamattomia naisia.
Näkyykö miesten optimistisempi asenne naisten viehättävyyttä kohtaan sitten naisten itsetunnossa? Koska naiset näyttäytyvät odottavan miesten miellyttävyydeltä vähemmän kuin miehet heiltä, loogisesti naisten tulisi osoittaa korkeampaa tietoisuutta omasta "markkina-arvostaan" deittailumarkkinoilla. Kyselylomakkeella kysyttiin, että kuinka monen he uskovat 20 pian tapaamastaan partnerista haluavan nähdä heidät tulevaisuudessakin. Mitä korkeampi vastaus, sitä viehättävämpänä vastaaja pitää itseään. Näkyykö sukupuolten välillä eroa tässä muuttujassa? Valitettavasti kysymykseen on paljon vähemmän vastauksia kuin ylläolevaan, joten ero on vaikeampi saada selville.

Siirrytään lopuksi miesten ja naisten odotuksista aitoon käyttäytymiseen. Jokainen pikadeittailija päättää jokaisen tapaamansa pikakumppanin kohdalla, että haluaako hän tavata häntä jatkossakin vai ei. Tämän lisäksi hän arvioi kumppanin kuudella asteikolla, jotka ovat ulkonäkö (=attr_o), vilpittömyys (=sinc_o), älykkyys (=intel_o), hauskuus (=fun_o), kunnianhimo (=amb_o) sekä kuinka paljon heillä on hänen mielestään yhteisiä harrastuksia sekä mielenkiinnon kohteita (=shar_o). Tahtovatko miehet nähdä kumppania naisia useammin ja miten eri ominaisuudet vaikuttavat todennäköisyyteen tulla hyväksytyksi niin miehillä kuin naisilla?
Naiset kelpuuttavat 36,5 % miehistä toisille treffeille 4 minuutin pikatutustumisen jälkeen. Miehiin taasen teki riittävän vaikutuksen 47,5 % naisista. Tässäkin siten havaitaan naisten korkeammat kriteerit kumppanille. Odotukset omasta viehätysvoimasta olivat sukupuolten välillä suurin piirtein samat, mutta todellisuus oli miehille karumpi. Kolmesta täyttä 20 valloitusta odottaneesta Casanovastakaan yksikään ei saanut kaikkia (lopulta kymmentä) kumppania valloitetuksi. Kaikki tosin voittivat 36,5 prosentin keskiarvon, yhden hurmatessa jopa 9 naista, toisen 5 ja viimeisen 4.
Datasettini on varsin massiivinen tarjolla olevien muuttujien suhteen, joten keskityn tässä vain nopeasti muutamaan huomioon; kuinka miehet/naiset suhtautuvat etukäteen sokkotreffiensä laatuun, kuinka monen he uskovat olevan kiinnostuneen heistä ja mitkä ominaisuudet vaikuttavat siihen, että vastapuoli sanoo "kyllä" jatkotapaamiselle.
Yleisenä huomiona olen siirtynyt R-kielestä Pythoniin, koska töissä saan näperrellä R:n parissa nykyään aivan tarpeeksi. Blogi siirtyy siis tavallaan taas aivan alkuaikoihin, kun koitan opetella uutta ohjelmointikieltä ja motivoida itseäni blogin kirjoittamisella. Ehkä tämä blogi tulee kielen muutoksen seurauksena aktivoitumaan. Ehkä ei. Ainakin analyysieni tekninen toteutustaso ottaa takapakkia.
Mutta aloitetaan pureutuminen deittailun maailmaan!
Naisia kritisoidaan nykyään paljon siitä, että he ovat niin nirsoja ja asettavat miehille korkeat kriteerit. Tunnetusti Tinderissä naiset "swaippaavat vasemmalle" moninkertaisella todennäköisyydellä suhteessa miehiin. Perinteisemmillä nettideittailusivustoilla naiset hukkuvat miesten yhteydenottoihin, mutta miehet saavat naisilta yhteydenoton paljon harvemmin (Christian Rudderin Dataclysm-kirja sisältää paljon mielenkiintoista dataa kirjoittajan perustamalta OKCupid-sivustolta, voin suositella tutustumaan). Miten nämä nettideittailussa havaitut toimintamallit jalkautuvat speed dating-maailmaan?
Ylläolevasta kuviosta nähdään naisten ja miesten odotus tyytyväisyyteen tilaisuudessa tapaamiaan ihmisiä kohtaan, skaalalla 0-10, jossa 10 = täysin tyytyväinen. Histogrammista nähdään, että miesten odotukset ovat keskimäärin korkeammat kuin naisten. Naisten jakauma on selvästi enemmän vasemmalle kallellaan kuin miesten. Miesten keskiarvo tyytyväisyydelleen onkin 5,85, naisten 5,18. Ero on yli puoli "tyytyväisyysyksikköä". Se ei ole massiivinen, kuten Tinderissä ja OKCupidissa havaitut erot käyttäytymisessä, mutta selkeästi naisilla on lähtökohtaisesti skeptisempi asenne potentiaalisia miehiä kohtaan kuin miehillä vielä tapaamattomia naisia.
Näkyykö miesten optimistisempi asenne naisten viehättävyyttä kohtaan sitten naisten itsetunnossa? Koska naiset näyttäytyvät odottavan miesten miellyttävyydeltä vähemmän kuin miehet heiltä, loogisesti naisten tulisi osoittaa korkeampaa tietoisuutta omasta "markkina-arvostaan" deittailumarkkinoilla. Kyselylomakkeella kysyttiin, että kuinka monen he uskovat 20 pian tapaamastaan partnerista haluavan nähdä heidät tulevaisuudessakin. Mitä korkeampi vastaus, sitä viehättävämpänä vastaaja pitää itseään. Näkyykö sukupuolten välillä eroa tässä muuttujassa? Valitettavasti kysymykseen on paljon vähemmän vastauksia kuin ylläolevaan, joten ero on vaikeampi saada selville.

Pienellä otoskoolla jakaumista ei tällä kertaa saa selvää vastausta. Sukupuolten keskiarvot ovat käytännössä samat, miehillä 5,9 ja naisilla 5,87. Erot ovat kuitenkin nähtävissä: miehistä löytyy muutama oman elämänsä Casanova, jotka kelpaavat omasta mielestään kaikille pikadeittailukumppaneilleen. Naisista löytyy enemmän oman elämänsä hylkiöitä, jotka eivät mielestään tule kelpaamaan kenellekään, toisaalta vain yhdelle tai kahdelle kumppanille mielestään kelpaavissa miehiä on moninkertainen määrä. Pienen aineiston perusteella emme siis voi havaita merkittävää eroa siinä, että naiset pitäisivät omaa markkina-arvoaan miehiä lähtökohtaisesti korkeampana.
Siirrytään lopuksi miesten ja naisten odotuksista aitoon käyttäytymiseen. Jokainen pikadeittailija päättää jokaisen tapaamansa pikakumppanin kohdalla, että haluaako hän tavata häntä jatkossakin vai ei. Tämän lisäksi hän arvioi kumppanin kuudella asteikolla, jotka ovat ulkonäkö (=attr_o), vilpittömyys (=sinc_o), älykkyys (=intel_o), hauskuus (=fun_o), kunnianhimo (=amb_o) sekä kuinka paljon heillä on hänen mielestään yhteisiä harrastuksia sekä mielenkiinnon kohteita (=shar_o). Tahtovatko miehet nähdä kumppania naisia useammin ja miten eri ominaisuudet vaikuttavat todennäköisyyteen tulla hyväksytyksi niin miehillä kuin naisilla?
Naiset kelpuuttavat 36,5 % miehistä toisille treffeille 4 minuutin pikatutustumisen jälkeen. Miehiin taasen teki riittävän vaikutuksen 47,5 % naisista. Tässäkin siten havaitaan naisten korkeammat kriteerit kumppanille. Odotukset omasta viehätysvoimasta olivat sukupuolten välillä suurin piirtein samat, mutta todellisuus oli miehille karumpi. Kolmesta täyttä 20 valloitusta odottaneesta Casanovastakaan yksikään ei saanut kaikkia (lopulta kymmentä) kumppania valloitetuksi. Kaikki tosin voittivat 36,5 prosentin keskiarvon, yhden hurmatessa jopa 9 naista, toisen 5 ja viimeisen 4.
Naiset siis vaativat mieheltä enemmän ennen kuin he sanovat "kyllä" toisille treffeille. Mutta arvostavatko sukupuolet samalla tavalla kumppanin ominaisuuksia? Tähän hain vastausta tekemällä logistisen regression, jossa käytin kumppanin arvioita kuudella mainitulla asteikolla selittävinä muuttujina.
attr_o 1.620445
sinc_o 0.723257
intel_o 0.752947
fun_o 1.248377
amb_o 0.797075
shar_o 1.284619
Miesten arviot naisesta ja niiden vaikutus todennäköisyyten sanoa "kyllä" toisille treffeille
Miehillä tärkeintä on naisen ulkonäkö. Yhden pykälän lisäys ulkonäkö-skaalalla lisää todennäköisyyttä sanoa "kyllä" 1,6-kertaisesti. Naisen älykkyys, vilpittömyys ja kunnianhimo yllättäen laskivat (muiden muuttujien ollessa vakiona) todennäköisyyttä haluta nähdä häntä uudestaan. Hauskuus ja yhteiset mielenkiinnon kohteet lisäsivät todennäköisyyttä noin 1,25-kertaiseksi.
Yllättäen naisilla tulokset olivat samansuuntaiset:
attr_o 1.273116
sinc_o 0.843561
intel_o 0.781485
fun_o 1.256415
amb_o 0.783069
shar_o 1.287888
Naisille miehen ulkonäöllä ei ole niin suurta vaikutusta, mutta muiden muuttujien kertoimet ovat likipitäin samat kuin miesten mallissa. Siis kun kyseessä on nopea 4 minuutin tapaaminen, kummatkin sukupuolet keskittyvät toisen ulkonäköön ja huumorintajuun sekä mahdollisiin samoihin mielenkiinnon kohteisiin. Tämä on varsin loogista. 4 minuuttia on lyhyt aika. Jos toinen miellyttää silmää ja lyhyessä ajassa löytyy yhteinen mielenkiinnon kohde, on nämä paljon tärkeämpiä kuin toisen kunnianhimo tai älykkyys; neljässä minuutissa harvoin käsitellään toisen urasuunnitelmia tai keskustella Platon ajattelun meriiteistä ja heikkouksista.
Lyhyenä yhteenvetona: naiset lähtökohtaisesti odottavat heikompitasoisia miehiä kuin miehet naisia ja myös konkreettisesti kelpuuttavat heitä pienemmällä todennäköisyydellä jatkotapaamiseen neljän minuutin pikatutustumisen jälkeen. Sen sijaan sukupuolten käsityksessä omasta viehätysvoimastaan ei ole pienestä aineistosta havaittavissa merkittävää eroa. Aineisto on vanha ja toisesta kulttuurista, mutta väittäisin tehtyjen havaintojen enemmän tai vähemmän myös sopivan Suomeen.
torstai 26. lokakuuta 2017
Mistä asuntojen hinta koostuu?
Kun vajaa vuosi sitten liityin asuntovelallisten kunnianarvoiseen joukkoon, alkoi minuakin yhtäkkiä kiinnostaa lainojen marginaalit ja neliöhinnat. Asunnon ostamisen aikaan tarkastin lähinnä Tilastokeskuksen aineistoista hakemani postinumeroalueen viimeisimmän tiedon mukaisen keskimääräisen neliöhinnan asuntotyypin luokassa ja postinumeroalueen hintakehityksen.
Näin jälkikäteen ajattelin tutkia hieman tieteellisemmin, että mistä se neliöhinta lopulta koostuu. Koska sijainti (Helsinki vs muu pääkaupunkiseutu vs muut isot kaupungit vs muu Suomi) on liian tylsä ja itsestään selvä vastaus, ei sitä eikä edes postinumeroalueella asuvien ihmisten määrää huomioida. Sen sijaan Tilastokeskuksen Paavo-palvelusta revitään irti sellaisia muuttujia kuin postinumeroalueen mediaanitulot, korkeakoulutettujen osuus väestöstä, mökkien osuus rakennuksista ja rakennusalan osuus työpaikoista. Mitkä alueen sosioekonomiset indikaattorit kertovat kalliista asuinalueesta?
Datana on vuosi 2015. En imputoi dataa mitenkään, joten kaikkiaan aineistoon jää jäljelle 880 postinumeroaluetta, sillä hyvin monen pienen postinumeroalueen osalta tieto on vähäisten kauppojen lukumäärän vuoksi salattu. Tämä iso vinouma aineistossa on huomioitava tuloksia tulkitessa.
Katsotaan ensiksi nopeasti korrelaatiomatriisista miten postinumeroalueen neliöhinta korreloi selittävien muuttujien kanssa. Nähdään, että kaikista voimakkain korrelaatio on korkeakoulutettujen osuudella väestöstä. Korkeakoulutettujen suuri määrä viittaa siis kalliiseen alueeseen. Tämä on varsin loogista tänä "kuplien" aikakautena, sillä voitaneen väittää ihmisen koulutustason olevan tulotasoakin voimakkaampi sosioekonomisen identifioitumisen väline. Ja ihmiset tunnetusti haluavat elää itsensä kaltaisten ihmisten kanssa, jolloin "paremman väen" kalleille alueille hakeutuvat korkeasti koulutetut; vielä voimakkaammin kuin ne, joilla on korkeat mediaanitulot ja varaa ostaa asunto kalliilta alueelta. Kolmantena käytännössä samaan selittävien muuttujien ryhmään kuuluva työllisyysaste on myös melko voimakkaasti positiivisesti korreloitunut neliöhinnan kanssa.
Sen sijaan eläkeläisten osuus ja alueen korkeampi keski-ikä kertovat alhaisemmasta hinta-tasosta. Vaikka eläkeläiset ovat Suomessa rikkaampia kuin koskaan aikaisemmin, ei heidän asuinalueensa kuitenkaan erotu hintatasollaan. Ehkä vanhemmat ihmiset hakeutuvat eläkkeelle rauhallisemmille alueille, joihin ei ole niin paljon tunkua.
Tavallaan loogisesti omistusasujien osuus on negatiivisesti korreloitunut neliöhinnan kanssa; kalliilla alueella pienemmällä joukolla ihmisiä on varaa omistaa asunto. Myös asumisväljyys on käänteisessä suhteessa neliöhintaan; ei ihme, kun miettii kuinka paljon Helsingin Kallion pikku luolista kehdataan pyytää.
Lisäksi nuorten lapsettomien talouksien osuus on voimakkaasti positiivisesti korreloitunut neliöhinnan kanssa. Nämä lienevätkin ihmisiä, jotka asuttavat Kallion ja Punavuoren kaltaisia trendialueita. Palvelualan työpaikkojen osuus on hieman positiivisesti korreloitunut neliöhinnan kanssa, mutta rakennusalan työpaikoilla ei ole mitään vaikutusta. Samoin varsin merkityksettömäksi jää asuntojen keski-pinta-ala sekä kesämökkien osuus.
Korrelaatioita tutkimalla ei kuitenkaan päästä pitkälle. Esimerkiksi oletus lineaarisesta trendistä muuttujien välillä on usein naiivi. Alla muutama sirontakuvio, joka havainnollistaa asiaa. (muuttujat on skaalattu samalle arvoasteikolle kuvioiden selkiyttämiseksi)
Korkeakoulutettujen sirontakuvio on hämmentävän siististi käyttäytyvä. Sen sijaan kolmessa muussa havaitaan loess-käyrää tuijottamalla pientä epälineaarisuutta. Tosin asumisväljyyden ja lapsettomien talouksien kohdalla muutoksen aiheuttaa enimmäkseen muutama poikkeava havainto, muuten niissäkin on havaittavissa enimmäkseen lineaarinen vaikutussuhde. Omistusasujat on vaikeampi ja siinä näyttäisi olevan aitoa epälineaarisuutta. Tämä selviääkin kokeilemalla sovittaa polynominen regressio sekä yleistetty additiivinen malli kyseiselle muuttujalla. Alla polynomisen regression tulokset:
Coefficients:
Estimate Std. Pr(>|t|)
(Intercept) -940.2283 0.0244 *
poly(opiskelijat, 3, raw = TRUE)1 528.9164 0.0000000152 ***
poly(opiskelijat, 3, raw = TRUE)2 -27.6730 0.0000052742 ***
poly(opiskelijat, 3, raw = TRUE)3 0.4327 0.0000561982 ***
Koska tässä on kuitenkin tarkoitus ennemminkin tulkita ja ymmärtää asunnon neliöhinnan kanssa korreloivia tekijöitä kuin sovittaa paras mahdollinen malli, teen tulkinnat yksinkertaisuuden vuoksi perinteisestä lineaarisesta regressiosta. Käytän tosin lasso-regressiota, joka suorittaa automaattista muuttujien valintaa "rankaisemalla" regressiokertoimia erillisellä termillä. Näin käytännössä merkityksettömien selittävien muuttujien kerroin lähenee nollaa ja jäljelle jää merkitykselliset termit.
(Intercept) -2213.3834188
keski_ika 70.0156752
mediaanitulot 53.7432632
asumisvaljyys -57.2494851
asuntojenPintaAlaKA .
elakelaisia -28.4794538
lapsettomatTaloudet 48.2953638
opiskelijat -57.9906649
omistusasujat -18.3675480
rakennusalanOsuus 0.4398833
palvelualanOsuus -0.2196908
tyollisyysaste 47.0407909
korkeakoulutetut 69.4857300
kesamokkienOsuus 0.2637277
Asunnon keskipinta-ala tippuu kokonaan pois mallista ja palvelualan ja rakennusalan työpaikkojen sekä kesämökkien osuuksien merkitys jää hyvin pieneksi. Yhden vuoden lisäys keski-ikään ja yhden prosentin lisäys korkeakoulutettujen osuuteen lisäävät neliöhintaa noin 70 eurolla, tuhannen euron lisäys mediaanituloihin 53 ja prosentin lisäys työllisyysasteen 47 eurolla. Sen sijaan yksikön lisäys asumisväljyyteen (Tilastokeskuksen virallinen määritelmä: Asumistiheys on asunnon koon ja siinä asuvien henkilöiden lukumäärän välinen suhdeluku. Asunnon koko ilmaistaan joko huonelukuna tai asunnon pinta-alana.)
aiheuttaa 57 euron tiputuksen neliöhintaan, opiskelijoiden osuus lisäys yhdellä prosenttiyksiköllä vajaan 58 euron.
Tein lopuksi vielä päätöspuun. Se on tylsä. Käytännössä korkeakoulutettujen osuus tulee joka toisessa tienristeyksessä vastaan:
Jos siis asuu alueella, jolla korkeakoulutettujen osuus väestöstä on yli 24 prosenttia ja asuntojen keskipinta-ala yli 77 neliötä, joutuu yhdestä neliömetristä pulittamaan yli 5500 euroa. Sen sijaan jos postinumeroalueella asuu korkeakoulutettuja alle 4,4 prosenttia väestöstä, selviää alle 1000 eurolla. Noin niin kuin keskimäärin.
Omalla postinumeroalueellani asuu noin 10 % korkeakoulutettuja. Maksoin mielestäni aivan liikaa neliöistäni...
Näin jälkikäteen ajattelin tutkia hieman tieteellisemmin, että mistä se neliöhinta lopulta koostuu. Koska sijainti (Helsinki vs muu pääkaupunkiseutu vs muut isot kaupungit vs muu Suomi) on liian tylsä ja itsestään selvä vastaus, ei sitä eikä edes postinumeroalueella asuvien ihmisten määrää huomioida. Sen sijaan Tilastokeskuksen Paavo-palvelusta revitään irti sellaisia muuttujia kuin postinumeroalueen mediaanitulot, korkeakoulutettujen osuus väestöstä, mökkien osuus rakennuksista ja rakennusalan osuus työpaikoista. Mitkä alueen sosioekonomiset indikaattorit kertovat kalliista asuinalueesta?
Datana on vuosi 2015. En imputoi dataa mitenkään, joten kaikkiaan aineistoon jää jäljelle 880 postinumeroaluetta, sillä hyvin monen pienen postinumeroalueen osalta tieto on vähäisten kauppojen lukumäärän vuoksi salattu. Tämä iso vinouma aineistossa on huomioitava tuloksia tulkitessa.
Katsotaan ensiksi nopeasti korrelaatiomatriisista miten postinumeroalueen neliöhinta korreloi selittävien muuttujien kanssa. Nähdään, että kaikista voimakkain korrelaatio on korkeakoulutettujen osuudella väestöstä. Korkeakoulutettujen suuri määrä viittaa siis kalliiseen alueeseen. Tämä on varsin loogista tänä "kuplien" aikakautena, sillä voitaneen väittää ihmisen koulutustason olevan tulotasoakin voimakkaampi sosioekonomisen identifioitumisen väline. Ja ihmiset tunnetusti haluavat elää itsensä kaltaisten ihmisten kanssa, jolloin "paremman väen" kalleille alueille hakeutuvat korkeasti koulutetut; vielä voimakkaammin kuin ne, joilla on korkeat mediaanitulot ja varaa ostaa asunto kalliilta alueelta. Kolmantena käytännössä samaan selittävien muuttujien ryhmään kuuluva työllisyysaste on myös melko voimakkaasti positiivisesti korreloitunut neliöhinnan kanssa.
Sen sijaan eläkeläisten osuus ja alueen korkeampi keski-ikä kertovat alhaisemmasta hinta-tasosta. Vaikka eläkeläiset ovat Suomessa rikkaampia kuin koskaan aikaisemmin, ei heidän asuinalueensa kuitenkaan erotu hintatasollaan. Ehkä vanhemmat ihmiset hakeutuvat eläkkeelle rauhallisemmille alueille, joihin ei ole niin paljon tunkua.
Tavallaan loogisesti omistusasujien osuus on negatiivisesti korreloitunut neliöhinnan kanssa; kalliilla alueella pienemmällä joukolla ihmisiä on varaa omistaa asunto. Myös asumisväljyys on käänteisessä suhteessa neliöhintaan; ei ihme, kun miettii kuinka paljon Helsingin Kallion pikku luolista kehdataan pyytää.
Lisäksi nuorten lapsettomien talouksien osuus on voimakkaasti positiivisesti korreloitunut neliöhinnan kanssa. Nämä lienevätkin ihmisiä, jotka asuttavat Kallion ja Punavuoren kaltaisia trendialueita. Palvelualan työpaikkojen osuus on hieman positiivisesti korreloitunut neliöhinnan kanssa, mutta rakennusalan työpaikoilla ei ole mitään vaikutusta. Samoin varsin merkityksettömäksi jää asuntojen keski-pinta-ala sekä kesämökkien osuus.
Korrelaatioita tutkimalla ei kuitenkaan päästä pitkälle. Esimerkiksi oletus lineaarisesta trendistä muuttujien välillä on usein naiivi. Alla muutama sirontakuvio, joka havainnollistaa asiaa. (muuttujat on skaalattu samalle arvoasteikolle kuvioiden selkiyttämiseksi)
Korkeakoulutettujen sirontakuvio on hämmentävän siististi käyttäytyvä. Sen sijaan kolmessa muussa havaitaan loess-käyrää tuijottamalla pientä epälineaarisuutta. Tosin asumisväljyyden ja lapsettomien talouksien kohdalla muutoksen aiheuttaa enimmäkseen muutama poikkeava havainto, muuten niissäkin on havaittavissa enimmäkseen lineaarinen vaikutussuhde. Omistusasujat on vaikeampi ja siinä näyttäisi olevan aitoa epälineaarisuutta. Tämä selviääkin kokeilemalla sovittaa polynominen regressio sekä yleistetty additiivinen malli kyseiselle muuttujalla. Alla polynomisen regression tulokset:
Coefficients:
Estimate Std. Pr(>|t|)
(Intercept) -940.2283 0.0244 *
poly(opiskelijat, 3, raw = TRUE)1 528.9164 0.0000000152 ***
poly(opiskelijat, 3, raw = TRUE)2 -27.6730 0.0000052742 ***
poly(opiskelijat, 3, raw = TRUE)3 0.4327 0.0000561982 ***
Koska tässä on kuitenkin tarkoitus ennemminkin tulkita ja ymmärtää asunnon neliöhinnan kanssa korreloivia tekijöitä kuin sovittaa paras mahdollinen malli, teen tulkinnat yksinkertaisuuden vuoksi perinteisestä lineaarisesta regressiosta. Käytän tosin lasso-regressiota, joka suorittaa automaattista muuttujien valintaa "rankaisemalla" regressiokertoimia erillisellä termillä. Näin käytännössä merkityksettömien selittävien muuttujien kerroin lähenee nollaa ja jäljelle jää merkitykselliset termit.
(Intercept) -2213.3834188
keski_ika 70.0156752
mediaanitulot 53.7432632
asumisvaljyys -57.2494851
asuntojenPintaAlaKA .
elakelaisia -28.4794538
lapsettomatTaloudet 48.2953638
opiskelijat -57.9906649
omistusasujat -18.3675480
rakennusalanOsuus 0.4398833
palvelualanOsuus -0.2196908
tyollisyysaste 47.0407909
korkeakoulutetut 69.4857300
kesamokkienOsuus 0.2637277
Asunnon keskipinta-ala tippuu kokonaan pois mallista ja palvelualan ja rakennusalan työpaikkojen sekä kesämökkien osuuksien merkitys jää hyvin pieneksi. Yhden vuoden lisäys keski-ikään ja yhden prosentin lisäys korkeakoulutettujen osuuteen lisäävät neliöhintaa noin 70 eurolla, tuhannen euron lisäys mediaanituloihin 53 ja prosentin lisäys työllisyysasteen 47 eurolla. Sen sijaan yksikön lisäys asumisväljyyteen (Tilastokeskuksen virallinen määritelmä: Asumistiheys on asunnon koon ja siinä asuvien henkilöiden lukumäärän välinen suhdeluku. Asunnon koko ilmaistaan joko huonelukuna tai asunnon pinta-alana.)
aiheuttaa 57 euron tiputuksen neliöhintaan, opiskelijoiden osuus lisäys yhdellä prosenttiyksiköllä vajaan 58 euron.
Tein lopuksi vielä päätöspuun. Se on tylsä. Käytännössä korkeakoulutettujen osuus tulee joka toisessa tienristeyksessä vastaan:
Jos siis asuu alueella, jolla korkeakoulutettujen osuus väestöstä on yli 24 prosenttia ja asuntojen keskipinta-ala yli 77 neliötä, joutuu yhdestä neliömetristä pulittamaan yli 5500 euroa. Sen sijaan jos postinumeroalueella asuu korkeakoulutettuja alle 4,4 prosenttia väestöstä, selviää alle 1000 eurolla. Noin niin kuin keskimäärin.
Omalla postinumeroalueellani asuu noin 10 % korkeakoulutettuja. Maksoin mielestäni aivan liikaa neliöistäni...
lauantai 22. heinäkuuta 2017
Luo oma Suomi24-viestisi!
Hiljaisena kesäloma-aamuna voi vaikka tehdä Shiny-applikaation, joka generoi Suomi24-viestejä Markovin ketjuilla, koska miksi ei?
Applikaatio on hyvin yksinkertainen: valitset haluamasi alapalstan (=tyylilajin) ja saat sen teemaisen viestin. Keskimäärin generoidut postaukset ovat suurin piirtein yhtä järkeviä kuin itse palstalle aidosti kirjoitetut.
https://lassewinter.shinyapps.io/suomishiny/
Applikaatio on hyvin yksinkertainen: valitset haluamasi alapalstan (=tyylilajin) ja saat sen teemaisen viestin. Keskimäärin generoidut postaukset ovat suurin piirtein yhtä järkeviä kuin itse palstalle aidosti kirjoitetut.
https://lassewinter.shinyapps.io/suomishiny/
tiistai 13. kesäkuuta 2017
Halla-aholaisuuden nousu ja tuho - Suomi24-palstan reaktio
Ajanjakso lauantaista 10.6.2017 tiistaihin 13.6.2017 jää Suomen poliittiseen historiaan uniikkina tapahtumasarjana, joka voittaa mielenkiintoisuudessaan mutkaisimmatkin House of Cardsin juonet. Tässä ei liene tarkoituksenmukaista käydä lävitse tapahtumia aina Halla-aholaisten palatsivallankaappauksesta soinilaisten irtautumiseen omaksi hallituksessa jatkavaksi eduskuntaryhmäkseen. Tapahtumaketju on puhuttanut ympäri maata. Ja siellä missä puhutaan, siellä tuotetaan dataa ja siellä missä on dataa, voi leikkiä.
Kävin hakemassa kahdelta eri Suomi24:n keskustelufoorumin alapalstalta, Yleistä politiikasta sekä Perussuomalaiset viimeaikaiset keskustelut, jotka luonnollisesti liikkuivat perussuomalaisten juonenkäänteiden ja yleisemmin #hallituskriisin ympärillä. Alla on comparison cloud kahden alapalstan keskusteluista. Comparison cloud keskittyy erityisesti sanoihin, jotka esiintyvät usein toisen alapalstan keskuteluissa, mutta ei toisen.
Sanojen perusteella yleisellä puolella puhuttiin enemmän muun hallituksen näkökulmasta. Persujen omalla alapalstalla Soinin ja Halla-ahon henkilöt puhuttivat paljon. Sanapilvi ei ole hirveän informatiivinen ja kiinnostavampaa olikin selvittää, että oliko kahdella eri palstalla erilainen sävy keskustelussa. Käytin omaa varsin vaillinaista sanalistaani tehdäkseni yksinekertaisen tunneanalyysin.
Yleistä politiikasta
negatiivinen neutraali positiivinen
59 (39%) 75 (49%) 19 (12%)
Perussuomalaiset
negatiivinen neutraali positiivinen
152 (44%) 116 (34%) 75 (22%)
Yleisellä palstalla keskustelu oli siis neutraalimpaa ja vähemmän tunteikasta. Perussuomalaisten palsta taas oli voimakkaammin jakautunut positiivisiin ja negatiivisiin viesteisin. Tästä ei voida vielä vetää johtopäätöstä, että keskustelusta olisi myös löydettävissä puolueen kahtia repineet halla-aholaiset ja soinilaiset fraktiot, mutta viitteitä siihen suuntaan on nähtävissä, varsinkin kun "natsit" ja "huoripukki" esiintyivät usein perussuomalaisten palstan keskustelussa Timon ja Jussin ohella. Kun kirjoitushetkellä kaksi ylimpänä ollutta keskustelua olivat Halla-ajo romutti puolueen ennätysajassa sekä Raukkamaista, Soini, raukkamaista!, voitaneen päätelmä todeta validoiduksi.
Tämän hätäisesti tuotetun pika-analyysin voisin lopettaa ottamalla pois data-analyytikon viitan ja kerrankin leikkiä lauseen tai kahden verran poliittista kommentoijaa.
Halla-aholaiset tekivät puoluekokoukseen suuren virheen tehdessään niin täydellisen vallankaappauksen. Oletan, että kahden soinilaisen valitseminen varapuheenjohtajistoon Halla-ahon ja toisen nuivan seuraksi olisi pitänyt sekä puolueen hallituksessa, että yhtenäisenä. Nyt he haukkasivat poliittisina noviiseina liian ison palan kerralla ja vallankaappauksesta tuli lopulta varsinainen Pyrrhoksen voitto.
Mitä jatkossa? Perussuomalaisen puolueen uskottavuus otti ison kolauksen. Soinin ploki, jossa hän meni kirjoittamaan että "ajatus siitä, että loikkaisin perustamastani puolueesta on mieletön" asettaa koko "Uuden vaihtoehdon" surkuhupaisaan valoon. Jos loikkarien eduskuntaryhmästä muodostuu puolue, niin kestää varmasti pitkään, ennen kuin se nauttii yhtään suurempaa luottamusta ja kansan suosiota. Perussuomalaiset on ja oli kuitenkin projekti, jonka ytimessä on vallanpitäjien ja vanhojen puolueiden kritisointi. Iso osa perussuomalaisten kannattajista oli jo valmiiksi pettyneitä kokiessaan puolueen johdon vaihtaneen puolueen ydinsanoman ministeri-Audiin. Vaikka loikkausta voi perustella irrottautumalla halla-aholaisesta ääriaineksesta, jättää se myös kuvan vallanhimoisesta ja pöhöttyneestä puolue-eliitistä, joka ei osannut päästää vallankahvasta irti kerran hallitukseen päästyään.
Entäs sitten Halla-ahon persut? Puolueorganisaation nitistessä liitoksistaan ja tukisäätiön kontrolloidessa rahahanoja puolueen kestää vuosi, kaksi edes koota rivinsä. Jatkossa puolue tullee olemaan ruotsidemokraattien kopio, mutta uuden jytkyn saapumiseen menee hetki, varsinkin kun iso osa edes etäisesti uskottavista poliitikoista on hyppäämässä laivasta ja jäljelle jää Hakkaraisen ja Huhtasaaren kaltaisia hörhöjä, jotka ovat isolle osalle Suomen kansasta punaisia vaatteita. Halla-ahon Perussuomalaiset on loikkarien potentiaalisesta uutta puoluetta potentiaalisesti uskottavampi poliittinen liike, mutta se jää ja ajetaan poliittiseen marginaaliin yhden asian liikkeenä.
Soini tarvitsi maahanmuuttokriitikoiden ääniä jytkyä varten, mutta Halla-aho tarvitsisi Soinin puolueorganisaatiota ja myös maltillisempia ja yhteistyökykyisiä soinilaisia saavuttaakseen oman jytkynsä. Yhden jakautuessa kahdeksi, osien summa jää kokonaisuutta pienemmäksi.
Tämän hätäisesti tuotetun pika-analyysin voisin lopettaa ottamalla pois data-analyytikon viitan ja kerrankin leikkiä lauseen tai kahden verran poliittista kommentoijaa.
Halla-aholaiset tekivät puoluekokoukseen suuren virheen tehdessään niin täydellisen vallankaappauksen. Oletan, että kahden soinilaisen valitseminen varapuheenjohtajistoon Halla-ahon ja toisen nuivan seuraksi olisi pitänyt sekä puolueen hallituksessa, että yhtenäisenä. Nyt he haukkasivat poliittisina noviiseina liian ison palan kerralla ja vallankaappauksesta tuli lopulta varsinainen Pyrrhoksen voitto.
Mitä jatkossa? Perussuomalaisen puolueen uskottavuus otti ison kolauksen. Soinin ploki, jossa hän meni kirjoittamaan että "ajatus siitä, että loikkaisin perustamastani puolueesta on mieletön" asettaa koko "Uuden vaihtoehdon" surkuhupaisaan valoon. Jos loikkarien eduskuntaryhmästä muodostuu puolue, niin kestää varmasti pitkään, ennen kuin se nauttii yhtään suurempaa luottamusta ja kansan suosiota. Perussuomalaiset on ja oli kuitenkin projekti, jonka ytimessä on vallanpitäjien ja vanhojen puolueiden kritisointi. Iso osa perussuomalaisten kannattajista oli jo valmiiksi pettyneitä kokiessaan puolueen johdon vaihtaneen puolueen ydinsanoman ministeri-Audiin. Vaikka loikkausta voi perustella irrottautumalla halla-aholaisesta ääriaineksesta, jättää se myös kuvan vallanhimoisesta ja pöhöttyneestä puolue-eliitistä, joka ei osannut päästää vallankahvasta irti kerran hallitukseen päästyään.
Entäs sitten Halla-ahon persut? Puolueorganisaation nitistessä liitoksistaan ja tukisäätiön kontrolloidessa rahahanoja puolueen kestää vuosi, kaksi edes koota rivinsä. Jatkossa puolue tullee olemaan ruotsidemokraattien kopio, mutta uuden jytkyn saapumiseen menee hetki, varsinkin kun iso osa edes etäisesti uskottavista poliitikoista on hyppäämässä laivasta ja jäljelle jää Hakkaraisen ja Huhtasaaren kaltaisia hörhöjä, jotka ovat isolle osalle Suomen kansasta punaisia vaatteita. Halla-ahon Perussuomalaiset on loikkarien potentiaalisesta uutta puoluetta potentiaalisesti uskottavampi poliittinen liike, mutta se jää ja ajetaan poliittiseen marginaaliin yhden asian liikkeenä.
Soini tarvitsi maahanmuuttokriitikoiden ääniä jytkyä varten, mutta Halla-aho tarvitsisi Soinin puolueorganisaatiota ja myös maltillisempia ja yhteistyökykyisiä soinilaisia saavuttaakseen oman jytkynsä. Yhden jakautuessa kahdeksi, osien summa jää kokonaisuutta pienemmäksi.
tiistai 11. huhtikuuta 2017
Shiny kuntavaalien tulosten tarkastelun
Jatkona laiskaan citizen data scientist - sarjaan naputtelin uuden Shiny-applikaation, jolla voi tutkia kuntavaalien 2017 tuloksia. Tällä hetkellä palvelulla voi tehdä selittävän regressiomallin puolueen ääniosuuteen vaikuttavista tekijöistä, sirontakuvion kahden puolueen kannatuksesta sekä sirontakuvion puolueen ja yhden selittävän muuttujan välille.
Pitemmittä puheitta, eikun leikkimään!
https://lassewinter.shinyapps.io/vaalishiny/
Pitemmittä puheitta, eikun leikkimään!
https://lassewinter.shinyapps.io/vaalishiny/
sunnuntai 26. maaliskuuta 2017
Näkyykö hallitus-oppositioasetelma kuntavaaliehdokkaissa?
Kuntavaalit 2017 ovat muutaman viikon päässä, joten on aika siirtää katse tulevaan. Yle julkaisi pari päivää sitten oman vaalikoneensa datan avoimeen käyttöön, joten katsotaan mitä siitä saadaan irti! Suomen Kuvalehti ehtikin jo aineistosta tehdä oman tekstianalyysinsä ehdokkaiden vaalilupaus-kentistä.
Aikaisemmin kirjoitin parikin artikkelia Ylen eduskantavaalikonedatasta kun etsin yhtäläisyyksiä kansanedustajaehdokkaiden vastauksista. Varsinkin ennustavaa analytiikkaa hyödyntävässä mallissani kävi ilmi, että puolueilla on kyllä pitkälti selkeähköt identiteettinsä ja ehdokkaat ovat homogeenisempiä puolueiden sisällä kuin välillä.
Eduskuntavaalit ovat kuitenkin eri tarina verrattuna kuntavaaleihin. Jos eduskuntavaalit ovat politiikan liiga niin kuntavaalit ovat aladivarihöntsää; kyllä siellä huippunimet käyvät lämmittelemässä, mutta puolueiden pyrkiessä haalimaan mahdollisimman paljon ehdokkaita jokaiseen kuntaan ovat ovet avoimemmat ja seinät leveämmällä kuin eduskuntavaaleissa. Lisämausteensa peliin tuo alueelliset erot ja kuntien valtavasti poikkeava elinvoimaisuus; Helsingin keskustalainen ei ole sama otus kuin Kainuun syrjäkylän serkkunsa. Myös Ylen vaalikone lisää puolueen sisäisiä eroja, sillä kysymykset ovat eduskuntavaaleja riippuvaisempia vastaajan kunnasta. Oletusarvoisesti puolueet ovat kuitenkin edelleen tunnistettavia, mutta heterogeenisyys on suurempaa.
Puolueiden välisten erojen sijaan keskityn kuitenkin tällä kertaa hallitus/oppositio-asetelman tutkimiseen. Suomenkin lehdistön johtava narratiivi kuntavaaleihin on usein "hallituksen väliarvio", ei niinkään paikallispäättäjien valinta. Tämä vastaa valtio-opin teoriaa "toisen asteen vaaleista", jossa kuntavaalien merkitys äänestäjille on toissijainen parlamenttivaaleihin nähden. Kääntäen asetelma päälaelleen onkin hauska nähdä näkyykö hallitus/oppositio-asenne myös paikallisiin valtuustoihin pyrkivien divarijyrien vastauksissa. 2017 hallitus on vieläpä suhteellisen yhtenäinen oikeisto-konservativiinen blokki, joten todennäköisyys onnistumiseen on suurempi kuin Kataisen sateenkaarihallitukseen kuulumisen ennustaminen.
Kuntavaaliehdokkaiden vastausten lisäksi teen vielä ennustemallin käyttäen hyödyksi ehdokkaiden vaalikoneelle antamia tietoja heidän sosioekonomisesta asemastaan. Viime eduskuntavaalien aikaan onnistuin ennustamaan yllättävän tarkasti läpimenevät ehdokkaat näiden tietojen avulla; katsotaan voidaanko hallitus/oppositioasetelmaa tutkia samoin menetelmin. Lähtökohtaisesti ei, mutta kokeillaan.
Menetelmistä: käytän tukivektorikonetta ja random forestia, joiden lisäksi käytän dimensioiden vähentämiseksi pääkomponenttianalyysiä. Viimeistä lukuunottamatta kaikkia on jo tämän blogin historiassa käytetty, eikä niihin kannata tässä enempää paneutua. Viimeisestä voin sanoa sen verran, että pääkomponenttianalyysin tarkoitus on löytyy suuresta määrästä muuttujia pienempi joukko pääkomponentteja, jotka selittäisivät dataa mahdollisimman hyvin. Esimerkiksi vaalikonevastausten perusteella tehdyt nelikentät perustuvat jonkinlaiseen pääkomponentti- tai faktorianalyysiin, jossa lasketaan joukosta keskenään korreloivia vastauksia yksikäsitteinen luku, joka kuvaa kyseistä dimensiota. Pääkomponenttianalyysiä käytetään tässä osana tukivektorikone (jatkossa SVM)-mallinnusta, sillä alustavien testien mukaan SVM: ää ei saa sovitettua tarpeeksi jäykästi korkeadimensionaaliseen koko kysymyspatteriston sisältävään dataan.
Aineistoon ei saa sovitettua pääkomponenttimallia, joka selittäisi suuren osan varianssista. Kaksi ensimmäistä pääkomponenttia selittää yhteensä vain n. 21 prosenttia aineistossa esiintyvästä vaihtelusta. Tämä tarkoittaa sitä, että Ylen vaalikoneen kysymykset eivät muodosta selkeitä kokonaisuuksia tyyliin vasemmisto/oikeisto tai liberaali/konservatiivi, joiden sisällä ehdokkaat vastaisivat saman suuntaisesti kaikkiin patteristo-osion kysymyksiin.
Tässä kaksi ensimmäistä pääkomponenttia ja niihin 10 voimakkaimmin latautuvaa kysymystä.
Pääkomponentti 1:
X129.Kouluissa.pitaa.olla.vahintaan.kerran.viikossa.kasvisruokapaiva. -0.2827778
X138.Rakentamista.on.nopeutettava.kansalaisten.valitusoikeutta.rajoittamalla. 0.2754592
X135.Kunnallisten.terveyspalveluiden.yksityistaminen.tuo.palveluihin.tehokkuutta.ja.saastaa.kustannuksia. 0.2752507
X147.Jokaisen.pitaa.paasta.palveluiden.aarelle.joukkoliikenteella. -0.2650160
X141.Ymparisto..ja.luontoarvoista.voidaan.joustaa..jos.siten.voidaan.lisata.tyopaikkoja. 0.2555743
X143.Oman.kuntani.tulee.ottaa.vastaan.Suomesta.turvapaikan.saaneita. -0.2459348
X133.Nykyisten.kuntatyontekijoiden.tyopaikat.on.turvattava.sote.uudistuksessa. -0.2438184
X128.Kuntien.tulee.tarjota.lasten.paivahoidon.varhaiskasvatus.ilmaiseksi.kaikille.lapsille. -0.2433295
X244.Tarvitsemme.vahvaa.johtajuutta..joka.voi.korjata.ongelmat.ilman.tarvetta.kompromisseille. 0.2398265
X248.Suomessa.kaikilla.on.yhtalaiset.mahdollisuudet.rikkauteen.ja.onneen. 0.2357479
Pääkomponentti 2:
X1809.Kunnanvaltuutetun.tarkein.tehtava.on.puolustaa.oman.aanestajakuntansa.etuja. -0.3384631
X143.Oman.kuntani.tulee.ottaa.vastaan.Suomesta.turvapaikan.saaneita. 0.3196248 X201.Ennen.ei.ollut.paremmin...suomalaisen.elamantavan.muutokset.ovat.olleet.hyvasta. 0.2751113 X136.Avohoidon.suosiminen.mielenterveystyossa.luo.turvattomuuden.tunnetta. -0.2658305
X133.Nykyisten.kuntatyontekijoiden.tyopaikat.on.turvattava.sote.uudistuksessa. -0.2624327
X246.Pohjimmiltaan.elamassa.vallitsee.resurssi..ja.valtakilpailu..jossa.ei.parjaa.ilman.taistelua. -0.2489658
X1811.Sosiaali..ja.terveyspalveluiden.jarjestaminen.kuntalaisille.onnistuu.paremmin.maakuntahallinnolta.kuin.kunnaltani.itsenaisesti. 0.2430052
X132.Vanhuksilla.on.oltava.oikeus.palvelukotipaikkaan..koska.nykyinen.kotihoito.ei.ole.riittavaa. -0.2376379
X131.Koulujen.opetusryhmat.ovat.jo.niin.isoja..etta.oppiminen.hairiintyy. -0.2257555
X134.Sosiaali..ja.terveyspalveluiden.toimivuus.on.tarkeampaa.kuin.sijainti. 0.2161348
Molemmat pääkomponentit koostuvat (jopa osittain samoista) kysymyksistä, jotka mittaavat ehdokkaan asemoitumista vasemmisto/oikeisto sekä konservatiivi/liberaali-akseleille. Mediatalojen nelikentistä poiketen molemmat pääkomponenttini ovat siis näiden sekasikiöitä eivätkä spesifisti kumpaakaan.
Hallitus - ja oppositiopuolueiden ehdokkaat kahden pääkomponentin muodostamassa avaruudessa
Kuviosta nähdään, että hallitus- ja oppositiopuolueiden edustajien välillä on eroa lähinnä ensimmäisessä pääkomponentissa, jossa oppositioedustajat saavat keskimäärin korkeampia arvoja. SVM-mallin sovittaminen koko aineistoon (eduskuntapuolueiden ehdokkaat, reilu 16 000 tapausta). Malli on sovitettu melko joustavaksi, jolloin parille oppositiopuolueiden outlier-tapaukselle tulee oma luokitusalueensa.
Tukivektorikoneen ennustemalli kahden pääkomponentin muodostamassa avaruudessa
Nyt on jaariteltu tarpeeksi; miten ennustaminen lopulta onnistuu random forestilla ja pääkomponentti-SVM: llä?
Pääkomponentti-SVM:
Hallitus Oppositio
Hallitus 2422 413
Oppositio 667 1963
Random forest:
Hallitus Oppositio
Hallitus 2518 317
Oppositio 605 2025
Molemmat mallit saavat siis noin 80 % tapauksista luokiteltua oikein. Random forest on hieman parempi tarkkuudeltaan, mutta ottaen huomioon, että SVM hyödyntää vain kahta pääkomponenttia, jotka sisältävät vain noin 20 % koko aineiston informaatiosta, ei random forestin etu ole huomattava.
Mutta laajalti hallitus/oppositio-asetelma on siis havaittavissa puolueiden kunnallisvaaliehdokkaiden vaalikonevastauksissa. Sipilän hallituskokoonpano esittäytyy verrattain homogeenisenä blokkina, mikä vahvistaa kuntavaalien "hallituksen väliarvio"-narratiivia.
Entä taustamuuttujat? No, vaikka vaaleissa läpimenon niillä pystyikin yllättävän hyvin ennustamaan niin siinä suhteessa ei sentään ole selkeää hallitus/oppositio-jakoa ja sekä SVM, että random forest-mallien tulokset olivat kolikonheiton tasoa. Mutta kuten alla olevasta kuviosta nähdään, kyllä puolueiden välillä erojakin on näiltä osin. Tässä esimerkiksi ehdokkaiden sijoitusomaisuuden arvo puolueittain.
Kokoomuksen ja RKP:n ehdokkaiden omaisuus on muita puolueita suurempaa, Vasemmistoliitolla taasen on eniten ehdokkaita, joilla on tasan 0 euroa kiinni arvopapereissa.
Mainittakoon muuten, että 29 ehdokasta ilmoittaa vuosituloikseen yli 100 000 euroa, mutta myös, ettei heillä ole yhtään sijoituksia. Tässä joukossa on nimiä kuten Jan Vapaavuori, Anni Sinnemäki, Mikko Alatalo, Jussi Niinistö, Juhana Vartiainen sekä Tarja Filatov. Joko kyseiset politiikan konkarit elävät kädestä suuhun jetset-elämää, makuuttavat varojaan nollakorkoisilla pankkitileillä tai kertovat muunneltua totuutta. Esimerkiksi Helsingin tulevalta pormestarilta en toivoisi löytyvän yhtään yllämainituista ominaisuuksista, mutta eipä taida olla vaihtoehtoa.
Muokkaus: tarkemmin katsoen Ylen kyselyn asettelu ei ota kantaa sijoitusasuntoihin vaan siinä puhutaan vain arvopapereista. Otan sanojani takaisin varauksella.
Aikaisemmin kirjoitin parikin artikkelia Ylen eduskantavaalikonedatasta kun etsin yhtäläisyyksiä kansanedustajaehdokkaiden vastauksista. Varsinkin ennustavaa analytiikkaa hyödyntävässä mallissani kävi ilmi, että puolueilla on kyllä pitkälti selkeähköt identiteettinsä ja ehdokkaat ovat homogeenisempiä puolueiden sisällä kuin välillä.
Eduskuntavaalit ovat kuitenkin eri tarina verrattuna kuntavaaleihin. Jos eduskuntavaalit ovat politiikan liiga niin kuntavaalit ovat aladivarihöntsää; kyllä siellä huippunimet käyvät lämmittelemässä, mutta puolueiden pyrkiessä haalimaan mahdollisimman paljon ehdokkaita jokaiseen kuntaan ovat ovet avoimemmat ja seinät leveämmällä kuin eduskuntavaaleissa. Lisämausteensa peliin tuo alueelliset erot ja kuntien valtavasti poikkeava elinvoimaisuus; Helsingin keskustalainen ei ole sama otus kuin Kainuun syrjäkylän serkkunsa. Myös Ylen vaalikone lisää puolueen sisäisiä eroja, sillä kysymykset ovat eduskuntavaaleja riippuvaisempia vastaajan kunnasta. Oletusarvoisesti puolueet ovat kuitenkin edelleen tunnistettavia, mutta heterogeenisyys on suurempaa.
Puolueiden välisten erojen sijaan keskityn kuitenkin tällä kertaa hallitus/oppositio-asetelman tutkimiseen. Suomenkin lehdistön johtava narratiivi kuntavaaleihin on usein "hallituksen väliarvio", ei niinkään paikallispäättäjien valinta. Tämä vastaa valtio-opin teoriaa "toisen asteen vaaleista", jossa kuntavaalien merkitys äänestäjille on toissijainen parlamenttivaaleihin nähden. Kääntäen asetelma päälaelleen onkin hauska nähdä näkyykö hallitus/oppositio-asenne myös paikallisiin valtuustoihin pyrkivien divarijyrien vastauksissa. 2017 hallitus on vieläpä suhteellisen yhtenäinen oikeisto-konservativiinen blokki, joten todennäköisyys onnistumiseen on suurempi kuin Kataisen sateenkaarihallitukseen kuulumisen ennustaminen.
Kuntavaaliehdokkaiden vastausten lisäksi teen vielä ennustemallin käyttäen hyödyksi ehdokkaiden vaalikoneelle antamia tietoja heidän sosioekonomisesta asemastaan. Viime eduskuntavaalien aikaan onnistuin ennustamaan yllättävän tarkasti läpimenevät ehdokkaat näiden tietojen avulla; katsotaan voidaanko hallitus/oppositioasetelmaa tutkia samoin menetelmin. Lähtökohtaisesti ei, mutta kokeillaan.
Menetelmistä: käytän tukivektorikonetta ja random forestia, joiden lisäksi käytän dimensioiden vähentämiseksi pääkomponenttianalyysiä. Viimeistä lukuunottamatta kaikkia on jo tämän blogin historiassa käytetty, eikä niihin kannata tässä enempää paneutua. Viimeisestä voin sanoa sen verran, että pääkomponenttianalyysin tarkoitus on löytyy suuresta määrästä muuttujia pienempi joukko pääkomponentteja, jotka selittäisivät dataa mahdollisimman hyvin. Esimerkiksi vaalikonevastausten perusteella tehdyt nelikentät perustuvat jonkinlaiseen pääkomponentti- tai faktorianalyysiin, jossa lasketaan joukosta keskenään korreloivia vastauksia yksikäsitteinen luku, joka kuvaa kyseistä dimensiota. Pääkomponenttianalyysiä käytetään tässä osana tukivektorikone (jatkossa SVM)-mallinnusta, sillä alustavien testien mukaan SVM: ää ei saa sovitettua tarpeeksi jäykästi korkeadimensionaaliseen koko kysymyspatteriston sisältävään dataan.
Aineistoon ei saa sovitettua pääkomponenttimallia, joka selittäisi suuren osan varianssista. Kaksi ensimmäistä pääkomponenttia selittää yhteensä vain n. 21 prosenttia aineistossa esiintyvästä vaihtelusta. Tämä tarkoittaa sitä, että Ylen vaalikoneen kysymykset eivät muodosta selkeitä kokonaisuuksia tyyliin vasemmisto/oikeisto tai liberaali/konservatiivi, joiden sisällä ehdokkaat vastaisivat saman suuntaisesti kaikkiin patteristo-osion kysymyksiin.
Tässä kaksi ensimmäistä pääkomponenttia ja niihin 10 voimakkaimmin latautuvaa kysymystä.
Pääkomponentti 1:
X129.Kouluissa.pitaa.olla.vahintaan.kerran.viikossa.kasvisruokapaiva. -0.2827778
X138.Rakentamista.on.nopeutettava.kansalaisten.valitusoikeutta.rajoittamalla. 0.2754592
X135.Kunnallisten.terveyspalveluiden.yksityistaminen.tuo.palveluihin.tehokkuutta.ja.saastaa.kustannuksia. 0.2752507
X147.Jokaisen.pitaa.paasta.palveluiden.aarelle.joukkoliikenteella. -0.2650160
X141.Ymparisto..ja.luontoarvoista.voidaan.joustaa..jos.siten.voidaan.lisata.tyopaikkoja. 0.2555743
X143.Oman.kuntani.tulee.ottaa.vastaan.Suomesta.turvapaikan.saaneita. -0.2459348
X133.Nykyisten.kuntatyontekijoiden.tyopaikat.on.turvattava.sote.uudistuksessa. -0.2438184
X128.Kuntien.tulee.tarjota.lasten.paivahoidon.varhaiskasvatus.ilmaiseksi.kaikille.lapsille. -0.2433295
X244.Tarvitsemme.vahvaa.johtajuutta..joka.voi.korjata.ongelmat.ilman.tarvetta.kompromisseille. 0.2398265
X248.Suomessa.kaikilla.on.yhtalaiset.mahdollisuudet.rikkauteen.ja.onneen. 0.2357479
Pääkomponentti 2:
X1809.Kunnanvaltuutetun.tarkein.tehtava.on.puolustaa.oman.aanestajakuntansa.etuja. -0.3384631
X143.Oman.kuntani.tulee.ottaa.vastaan.Suomesta.turvapaikan.saaneita. 0.3196248 X201.Ennen.ei.ollut.paremmin...suomalaisen.elamantavan.muutokset.ovat.olleet.hyvasta. 0.2751113 X136.Avohoidon.suosiminen.mielenterveystyossa.luo.turvattomuuden.tunnetta. -0.2658305
X133.Nykyisten.kuntatyontekijoiden.tyopaikat.on.turvattava.sote.uudistuksessa. -0.2624327
X246.Pohjimmiltaan.elamassa.vallitsee.resurssi..ja.valtakilpailu..jossa.ei.parjaa.ilman.taistelua. -0.2489658
X1811.Sosiaali..ja.terveyspalveluiden.jarjestaminen.kuntalaisille.onnistuu.paremmin.maakuntahallinnolta.kuin.kunnaltani.itsenaisesti. 0.2430052
X132.Vanhuksilla.on.oltava.oikeus.palvelukotipaikkaan..koska.nykyinen.kotihoito.ei.ole.riittavaa. -0.2376379
X131.Koulujen.opetusryhmat.ovat.jo.niin.isoja..etta.oppiminen.hairiintyy. -0.2257555
X134.Sosiaali..ja.terveyspalveluiden.toimivuus.on.tarkeampaa.kuin.sijainti. 0.2161348
Molemmat pääkomponentit koostuvat (jopa osittain samoista) kysymyksistä, jotka mittaavat ehdokkaan asemoitumista vasemmisto/oikeisto sekä konservatiivi/liberaali-akseleille. Mediatalojen nelikentistä poiketen molemmat pääkomponenttini ovat siis näiden sekasikiöitä eivätkä spesifisti kumpaakaan.
Hallitus - ja oppositiopuolueiden ehdokkaat kahden pääkomponentin muodostamassa avaruudessa
Kuviosta nähdään, että hallitus- ja oppositiopuolueiden edustajien välillä on eroa lähinnä ensimmäisessä pääkomponentissa, jossa oppositioedustajat saavat keskimäärin korkeampia arvoja. SVM-mallin sovittaminen koko aineistoon (eduskuntapuolueiden ehdokkaat, reilu 16 000 tapausta). Malli on sovitettu melko joustavaksi, jolloin parille oppositiopuolueiden outlier-tapaukselle tulee oma luokitusalueensa.
Tukivektorikoneen ennustemalli kahden pääkomponentin muodostamassa avaruudessa
Nyt on jaariteltu tarpeeksi; miten ennustaminen lopulta onnistuu random forestilla ja pääkomponentti-SVM: llä?
Pääkomponentti-SVM:
Hallitus Oppositio
Hallitus 2422 413
Oppositio 667 1963
Random forest:
Hallitus Oppositio
Hallitus 2518 317
Oppositio 605 2025
Molemmat mallit saavat siis noin 80 % tapauksista luokiteltua oikein. Random forest on hieman parempi tarkkuudeltaan, mutta ottaen huomioon, että SVM hyödyntää vain kahta pääkomponenttia, jotka sisältävät vain noin 20 % koko aineiston informaatiosta, ei random forestin etu ole huomattava.
Mutta laajalti hallitus/oppositio-asetelma on siis havaittavissa puolueiden kunnallisvaaliehdokkaiden vaalikonevastauksissa. Sipilän hallituskokoonpano esittäytyy verrattain homogeenisenä blokkina, mikä vahvistaa kuntavaalien "hallituksen väliarvio"-narratiivia.
Entä taustamuuttujat? No, vaikka vaaleissa läpimenon niillä pystyikin yllättävän hyvin ennustamaan niin siinä suhteessa ei sentään ole selkeää hallitus/oppositio-jakoa ja sekä SVM, että random forest-mallien tulokset olivat kolikonheiton tasoa. Mutta kuten alla olevasta kuviosta nähdään, kyllä puolueiden välillä erojakin on näiltä osin. Tässä esimerkiksi ehdokkaiden sijoitusomaisuuden arvo puolueittain.
Kokoomuksen ja RKP:n ehdokkaiden omaisuus on muita puolueita suurempaa, Vasemmistoliitolla taasen on eniten ehdokkaita, joilla on tasan 0 euroa kiinni arvopapereissa.
Mainittakoon muuten, että 29 ehdokasta ilmoittaa vuosituloikseen yli 100 000 euroa, mutta myös, ettei heillä ole yhtään sijoituksia. Tässä joukossa on nimiä kuten Jan Vapaavuori, Anni Sinnemäki, Mikko Alatalo, Jussi Niinistö, Juhana Vartiainen sekä Tarja Filatov. Joko kyseiset politiikan konkarit elävät kädestä suuhun jetset-elämää, makuuttavat varojaan nollakorkoisilla pankkitileillä tai kertovat muunneltua totuutta. Esimerkiksi Helsingin tulevalta pormestarilta en toivoisi löytyvän yhtään yllämainituista ominaisuuksista, mutta eipä taida olla vaihtoehtoa.
Muokkaus: tarkemmin katsoen Ylen kyselyn asettelu ei ota kantaa sijoitusasuntoihin vaan siinä puhutaan vain arvopapereista. Otan sanojani takaisin varauksella.
sunnuntai 18. joulukuuta 2016
Voimaannutan kansalaisdatatietelijöitä vai olen laiska? - Shiny
Blogin kirjoittamisen epämiellyttävin osuus on, no, kirjoittaminen. Älkää käsittäkö väärin, ei se epämiellyttävää ole. Minulla ei ole koskaan ollut kauheaa luomisen tuskaa kirjoittamisen yhteydessä tai tyhjän paperin pelkoa.
Se ei vain usein ole niin hauskaa kuin itse datan kanssa näpräily. Kun itse on kertaalleen saanut hauskan näpräilyn jälkeen datasta enemmän tai vähemmän innostavia oivalluksia, on niistä kaikelle kansalle kirjoittamisen hauskuus suoraan verrannollinen löydösten kiinnostavuuteen. Ja aina sen hauskuus jää jälkeen varsinaisen data-analyysin tekemisestä.
Miten siis optimoida hauskan koodinäpräilyn ja enemmän tai vähemmän miellyttävän kirjoittamisprosessin suhde? Vastaus on yksinkertainen.
Shiny.
Shiny on R:n kirjasto, jolla voi kirjoittaa erilaisia interaktiivisia applikaatioita. Sovelluksen voi jakaa kaikkien käyttöön erilaisten palvelimien kautta. Tällöin jokainen sovellusta käyttävä voi itse tutkia dataa osaamatta itse sen kummemmin koodata tai tuntematta tilastotiedettä, sovelluksen asettamien reunaehtojen puitteissa.
Koska kansalaisdatatieteilijöiden nousu on tällä hetkellä yksi data-alan isoista trendeistä, on vain soveliasta, että minäkin tarjoan lukijoille välineet tehdä löytöjä sen sijaan, että tekisin löydöt lukijoiden puolesta.
Siispä, saanen esitellä ensimmäisen Shiny-applikaationi!
Applikaatio käyttää hyväkseen Tilastokeskuksen tarjoamaan Paavo-rajapintaa, joka sisältää postinumeroalueittaista avointa dataa. Paavoa käytettiin vanhassa blogipostauksessani hyödyksi, mikä onkin Shiny-sovellukseni idean pohjana. Sovelluksessa voidaan tutkia halutun kunnan postinumeroalueita kahden muuttujan perusteella (yhteensä valittavana 13 muuttujaa). Applikaatio piirtää sirontakuvion, jossa havainnot väritetään kahteen tai useampaan väriin taustalla pyörivän k-means klusterointialgoritmin perusteella. Paavon data on vuodelta 2014, lukuunottamatta rakennustietoja (mökkien lukumäärä ja keskimääräinen asunnon pinta-ala) ja väestötietoja (keski-ikä ja asukasmäärä)
Ja ei muuta kuin tutkimaan! Ideoita uusista Shiny-applikaatioista saa lähettää, toteutan niitä osaamisen ja käytettävisen olevissa ajan mukaan.
Perinteisempien blogi-postauksien ystävien ei kuitenkaan tarvitse huolestua. Aion myös jatkossa kirjoittaa perinteisempien data-kikkailujeni tuloksia auki.
Otsikon kysymykseen muuten vielä oikea vastaus: ei kumpikaan, shiny-appsit ovat vaan pirun siistejä!
Se ei vain usein ole niin hauskaa kuin itse datan kanssa näpräily. Kun itse on kertaalleen saanut hauskan näpräilyn jälkeen datasta enemmän tai vähemmän innostavia oivalluksia, on niistä kaikelle kansalle kirjoittamisen hauskuus suoraan verrannollinen löydösten kiinnostavuuteen. Ja aina sen hauskuus jää jälkeen varsinaisen data-analyysin tekemisestä.
Miten siis optimoida hauskan koodinäpräilyn ja enemmän tai vähemmän miellyttävän kirjoittamisprosessin suhde? Vastaus on yksinkertainen.
Shiny.
Shiny on R:n kirjasto, jolla voi kirjoittaa erilaisia interaktiivisia applikaatioita. Sovelluksen voi jakaa kaikkien käyttöön erilaisten palvelimien kautta. Tällöin jokainen sovellusta käyttävä voi itse tutkia dataa osaamatta itse sen kummemmin koodata tai tuntematta tilastotiedettä, sovelluksen asettamien reunaehtojen puitteissa.
Koska kansalaisdatatieteilijöiden nousu on tällä hetkellä yksi data-alan isoista trendeistä, on vain soveliasta, että minäkin tarjoan lukijoille välineet tehdä löytöjä sen sijaan, että tekisin löydöt lukijoiden puolesta.
Siispä, saanen esitellä ensimmäisen Shiny-applikaationi!
Applikaatio käyttää hyväkseen Tilastokeskuksen tarjoamaan Paavo-rajapintaa, joka sisältää postinumeroalueittaista avointa dataa. Paavoa käytettiin vanhassa blogipostauksessani hyödyksi, mikä onkin Shiny-sovellukseni idean pohjana. Sovelluksessa voidaan tutkia halutun kunnan postinumeroalueita kahden muuttujan perusteella (yhteensä valittavana 13 muuttujaa). Applikaatio piirtää sirontakuvion, jossa havainnot väritetään kahteen tai useampaan väriin taustalla pyörivän k-means klusterointialgoritmin perusteella. Paavon data on vuodelta 2014, lukuunottamatta rakennustietoja (mökkien lukumäärä ja keskimääräinen asunnon pinta-ala) ja väestötietoja (keski-ikä ja asukasmäärä)
Ja ei muuta kuin tutkimaan! Ideoita uusista Shiny-applikaatioista saa lähettää, toteutan niitä osaamisen ja käytettävisen olevissa ajan mukaan.
Perinteisempien blogi-postauksien ystävien ei kuitenkaan tarvitse huolestua. Aion myös jatkossa kirjoittaa perinteisempien data-kikkailujeni tuloksia auki.
Otsikon kysymykseen muuten vielä oikea vastaus: ei kumpikaan, shiny-appsit ovat vaan pirun siistejä!
lauantai 17. joulukuuta 2016
Paljon liikuntaa, huono terveydentila ja viinaa - eurooppalainen kansanterveys eurooppalaisten kertomana
Aivan Euroopan kovimpia ryyppymiehiä ei täällä kuitenkaan olla; Tanskan huolettomat hyggeilijät vievät voiton myös tällä mittarilla mitattuna. Maailman onnellisimpien on helppo avata viinipullo. Mittarina alla olevassa kartassa käytetään vähintään kerran kuukaudessa kovaan humalaan ("heavy episodic drinking" käyttäen Eurostatin virallista termistöä) itsensä juovien osuutta.
Vähintään kerran kuukaudessa itsensä kovaan humalaan juovien osuus populaatiosta
Vaikka Suomen tuleva alkoholilainsäädännön uudistus nostaa taas kerran suomalaisen alkoholipolitiikan ja juomiskulttuurin esille, niin itsessään kuin suhteessa ympäröivään maailmaan, niin tässä postauksessa ei aiheesta enempää jutella.Varsinaista terveystieteellistä data-analyysiäkään ei harrasteta. Sen sijaan tässä käsitellään EU-valtioiden terveysprofiileja näiden maiden kansalaisten itse ilmoittaman tiedon perusteella. Miten erilaiset terveysindikaattorit korreloivat keskenään mitattuna valtiotasolla? Ja mitkä valtiot muistuttavat eniten toisiaan terveysprofiililtaan?
Aineistona käytetään Eurostatin lukuja vuodelta 2014. Aineiston lopullinen koko on valitettavasti vain 24 maata, sillä kaikista EU-maista ei dataa ole saatavilla. Valittuina muuttujina on jo mainittu vähintään kerran kuukaudessa kovempaa juomista harrastavien osuus, ylipainoisten (BMI > 25) osuus, melko tai hyvin masentuneiksi itsensä kokevien osuus, 5 tai enemmän hedelmä ja/tai vihannesannosta päivässä syövien osuus, päivittäin tupakoivien osuus, hyväksi tai erittäin hyväksi oman terveydentilansa kokevien osuus, vähintään 150 minuuttia viikossa urheilevien osuus sekä pitkäaikaissairaiden osuus. Muistaakseni. Tuhosin vahingossa koodit sen jälkeen kun tein kuvat. Hups. Joka tapauksessa, alla kuvio korrelaatioverkostosta muuttujien kesken.
Selittävien muuttujien korrelaatioverkosto
Valtiotasolla kova alkoholin kulutus on siis vahvasti kytköksissä säännölliseen liikkumiseen ja vähäiseen tupakointiin. Maissa, joissa ihmiset liikkuvat paljon, ihmiset myös kokevat olevansa sairaampia. Ylipainisemmissa maissa ihmiset kokevat olonsa terveemmäksi. Paljon tupakoivissa maissa masennusta on vähemmän. Viskipaukun tai viiden kanssa nautitaan hiukopalaksi virkistävä mandariini.
Kuten näemme, ihmisten terveysaiheisten vastausten aggregointi valtiotasolle ei tuota mikrotasolta odotettavissa olevia riippuvuussuhteita. Sen sijaan aineisto antaa mielenkiintoisen läåpileikkauksen eurooppalaisiin kulttuureihin ja elämäntapoihin.
EU-maat terveysprofiilin verkostograafissa
Yllä nähdään, että miten eri maat ovat linkittyneitä toisiinsa näiden terveysprofiilien perusteella. Mittarina käytetään euklidista etäisyyttä. Suomelle läheisiä ovat siis Tanskan ja Ruotsin kaltaisten pohjoismaiden lisäksi köyhät Romania ja Bulgaria. Myös Puolaan, Kreikkaan (EL), Liettuaan ja Italiaan linkki on verrattain voimakas.
Jos kuviota tulkitsee laajemmin niin näyttää siltä, että EU: sta löytyy terveysprofiililtaan samankaltaisten maiden ydin sekä joukko oman tien kulkijoita, joiden terveysprofiili ei valituilla mittareilla ole hirveän lähellä mitään toista maata. EU: ta ei siis voi terveyskentässä esimerkiksi jakaa selkeisiin pohjoinen/etelä tai itä/länsi-blokkeihin.
Tämä oli vain pintaraapaisu aiheeseen. Olisi mielenkiintoista tutkia, että miten ihmisten kyselytutkimuksissa itseilmoittamat mittarit korreloivat makrotasolla valtioiden mitattavissa oleviin terveysindikaattoreihin (esimerkiksi myyty alkoholin, tupakan ja vihannesten määrä per asukas, sairaspoissaolojen määrä). Jos EU-maiden tulisi unionin tulevaisuuden kannalta lähentyä niin poliittisesti kuin taloudellisesti toisiaan niin ihmisten kannalta oleellisena voitaisiin pitää myös terveydellistä lähentymistä; ja niin, että esimerkiksi ylipainoisten osuus laskisi, ei kasvaisi.
keskiviikko 9. marraskuuta 2016
Jenkkijytky Twitterissä: miten Trumpin voittoon reagoidaan?
Vuosi 2016 tullaan muistamaan poliittisten protestien vuotena, vuotena jolloin poliitikot heittivät faktat roskakoriin ja vaalit ratkaisi epämääräiset tunteet. Donald Trumpin valinta on itsessään suuri onnettomuus tuodessaan maailman voimakkaimman valtion johtoon miehen, josta emme oikeasti tiedä, että minkälaista politiikkaa hän tulee aidosti ajamaan seuraavan neljän vuoden ajan. Mutta vielä huolestuttavampaa on se iso kuva, johon Trumpin voitto asettuu; Trumpin valinta on jälleen yksi uusi isku liberaalin, avoimen, suvaitsevaisen maailman arkkuun, jota esimerkiksi Unkarin Orban, Puolan PiS ja brexit ovat jo pelkästään vuonna 2016 kovasti heikentäneet.
Kampanja-Trumpin kaikkia lupauksia presidentti-Trump ei tietenkään pysty täyttämään. Lähtökohtaisesti voimme kuitenkin odottaa ainakin ympäristöarvojen polkemista, luultavasti Pariisin sopimuksesta vetäytymistä, protektionistista kauppamuurien pystyttämistä sekä arvaamatonta ja epävakautta lisäävää ulkopolitiikkaa. Maailman ja planeetan ympäristö, talous ja turvallisuus tulevat kärsimään, enemmän tai vähemmän.
En aio tehdä monimutkaista data-analyysiä tai huolella kirjoitettua poliittista analyysiä. Satoja minua parempia kirjoittajia on kirjoittanut ja kirjoittaa aiheesta parempia artikkeleja. Teen tässä vain nopean analyysin, että millä fiiliksin Trumpin voitto otettiin vastaan. Omassa kuplassanihan Trumpin voittoa lähinnä kauhisteltiin. Syystä.
Aineistona on noin 1600 twiittiä, joissa mainitaan sana "Trump" (en tiedä miksi Twitterin apista ei minulle isompaa massaa tällä kertaa suotu). Teen aineistolle syuzhet-paketin avulla sentiment analysis-tarkastelua eli tutkin twiiteissä esiintyviä tunnetiloja.
Kun kaikki alle 0-AFINN-arvon negatiivisiksi ja yli nollan positiivisiksi, luokkien frekvenssit ovat seuraavat:
Twitterissä siis lievä enemmistö on positiivin mielin Trumpin voitosta. Ei ihme, voittihan hän vaalitkin.
Tässä vielä sanapilvi, jossa erotellaan negatiivisiksi ja positiiviksi luokiteltujen twiittien yleisimmät sanat.
"Shit". Ei lisättävää. No, neljä vuotta on lyhyt aika tuhota maapallo ja alle kolmekymppisten äänissä niin Clinton kuin Bremain olisivat olleet massiivisia voittajia.
Kampanja-Trumpin kaikkia lupauksia presidentti-Trump ei tietenkään pysty täyttämään. Lähtökohtaisesti voimme kuitenkin odottaa ainakin ympäristöarvojen polkemista, luultavasti Pariisin sopimuksesta vetäytymistä, protektionistista kauppamuurien pystyttämistä sekä arvaamatonta ja epävakautta lisäävää ulkopolitiikkaa. Maailman ja planeetan ympäristö, talous ja turvallisuus tulevat kärsimään, enemmän tai vähemmän.
En aio tehdä monimutkaista data-analyysiä tai huolella kirjoitettua poliittista analyysiä. Satoja minua parempia kirjoittajia on kirjoittanut ja kirjoittaa aiheesta parempia artikkeleja. Teen tässä vain nopean analyysin, että millä fiiliksin Trumpin voitto otettiin vastaan. Omassa kuplassanihan Trumpin voittoa lähinnä kauhisteltiin. Syystä.
Aineistona on noin 1600 twiittiä, joissa mainitaan sana "Trump" (en tiedä miksi Twitterin apista ei minulle isompaa massaa tällä kertaa suotu). Teen aineistolle syuzhet-paketin avulla sentiment analysis-tarkastelua eli tutkin twiiteissä esiintyviä tunnetiloja.
Kun kaikki alle 0-AFINN-arvon negatiivisiksi ja yli nollan positiivisiksi, luokkien frekvenssit ovat seuraavat:
negatiivinen positiivinen
749 845
Jos taas otetaan raaoista sentimenttiarvoista keskiarvo, on lopputulos 0.124.
Twitterissä siis lievä enemmistö on positiivin mielin Trumpin voitosta. Ei ihme, voittihan hän vaalitkin.
Tässä vielä sanapilvi, jossa erotellaan negatiivisiksi ja positiiviksi luokiteltujen twiittien yleisimmät sanat.
"Shit". Ei lisättävää. No, neljä vuotta on lyhyt aika tuhota maapallo ja alle kolmekymppisten äänissä niin Clinton kuin Bremain olisivat olleet massiivisia voittajia.
maanantai 31. lokakuuta 2016
Sukupuolten palkkatasa-arvo makrotason tarkastelussa
Tänään maanantaina 31.10 vietetään jälleen STTK:n järjestmämää naisten palkkapäivää eli päivää, jolloin naisten vuoden ansiot on jo "kasassa". Päivää voisi kutsua myös kansalliseksi tilastojen väärintulkitsemispäiväksi, sillä reilun 80 sentin arvoisen "naisten euron" luoma mielikuva miehille samasta työstä mystisesti sukupuolen perusteella maksettavasta palkkapreemiosta on täysin virheellinen.
Todellisuudessa miesten ja naisten saama palkkatulo samoista tehtävistä samanlaisella kokemuksella on lähes identtinen. Ei siis ole olemassa mitään 20 prosenttiyksikön mieslisää, jolla miehet tienaisivat samoista töistä enemmän kuin naiset. Sen sijaan sukupuolten välillä on eroja esimerkiksi ammattirakenteessa sekä tehdyissä työtunneissa, joiden vaikutukset saatuun palkkaan näyttäytyvät puusilmäisessä tarkastelussa sukupuolesta johtuvina palkkaeroina. Naisten ja miesten välinen ero ansiotuloissa on todellinen ja sisältää myös aitoja sukupuoli-perusteisia ongelmakohtia, joihin pitää puuttua. Mutta yksinkertaistamalla palkkaero binääriseksi kahden luokan väliseksi vertailuksi ilman muiden palkkaa selittävien muuttujien huomiointia kohdistuu huomio aivan vääriin asioihin.
Keskustelu palkkaerosta on siis usein aivan liian yksinkertaistettua eikä siinä huomioida mitään muuta kuin sukupuoli. Se on yhtä hedelmällistä kuin keskustella suomalaisten ja maahanmuuttajataustaisten rikollisuudesta käyttäen pelkästään etnisyyttä selittävänä tekijänä (maahanmuuttajat ovat esimerkiksi kantaväestöä nuorempia ja huono-osaisempia, mikä selittänee suuren osan havaituista eroista). Palkkaan vaikuttaa suuri määrä erilaisia muuttujia ja mikäli sukupuolten aitoa palkkaeroa halutaan tarkastella, tulee nämä taustatekijät ensiksi vakioida. Toisaalta jokainen tilastotiedettä vähänkin ymmärtävä tietää, että tarkasteluun valitut muuttujat muuttavat aina hieman tuloksia ja tehtäviä johtopäätöksiä, kuten Mika Malirantakin ansiokkaasti yllä linkkaamassani jutussa mainitsi. Siltikin mediassa paljon julkisuutta saaneen Milja Saaren väitöskirjassaan esittämä väite on huteralla pohjalla ja mielestäni suhteellisen heikko perusta tieteellisen tutkimuksen pohjaksi:
Mikrotasolla miesten ja naisten välistä palkkaeroa on tutkittu monen eri mallin voimin useaan kertaan, joista yksinkertaisin mallinnus on valitettavasti tunnetuin pelkän sukupuolen huomioiva"naisen euro"-päätelmä. Sen sijaan en ole aiemmin juuri törmännyt aiheen käsittelyyn rakenteellisella makrotasolla, jossa ihmisen asuinympäristö vaikuttaa myös sukupuolten väliseen tuloeroon. Tässä postauksessa tutkin miesten ja naisten palkkaeroa yksittäisten yksilöiden sijaan alueellisella makrotasolla; missä ja minkälaisissa kunnissa sukupuolten välinen ero palkkatuloissa on suurin?
Suomi on tunnetusti jakautunut voimakkaasti mies- ja naisaloihin ja ammatillinen segregaatio on EU:n kärkipäätä. Ammattijakauma on myös varsin poikkeava Suomen eri alueiden kesken, sillä esimerkiksi Kainuun perukoilla on huomattavasti vähemmän asiantuntijatehtäviä kuin suurissa kaupungeissa. Myös toimialarakenne tai esimerkiksi väestöllinen huoltosuhde ("vanhuskunnissa" tarvitaan enemmän naisvaltaisia hoitajia, joilla on yleisesti alhaiset palkat) ovat tekijöitä, jotka voivat makrotasolla johtaa suuriinkin kunnittaisiin eroihin eri sukupuolten ansiotasossa.
Aineistona minulla on Verohallinnon data päätoimen palkasta luontoisetuineen vuodelle 2014 (jaan vuoden kokonaispalkkatulot kahdellatoista, jotta saan approksimaation kuukausipalkasta) ja selittävinä muuttujina käytän logaritmia verovelvollisten määrästä (väestön määrän sijaan, logaritmi väestöjakauman vahvan vinouman vuoksi) sekä Tilastokeskukselta väestön koulutusmittaria (VKTM), työttömyystasoa, naisten työllisyysastetta, kuntien välistä muuttotasetta, väestöllistä huoltosuhdetta, ulkomaalaisten osuutta väestöstä sekä yritysten liikevaihtoa henkilöittäin.
Miesten ja naisten välinen tuloero kunnittain Suomessa 2014
Kun tuloerojen jakautumista tutkitaan alueittain niin huomataan, että hieman yllättäen tuloerot ovat suurimmat isoissa kaupungeissa ja niiden kehyskunnissa. Varsinkin Lapista löytyy toisaalta alueita, joissa naiset tienaavat miehiä paremmin. Kartan perusteella naisten suhteellinen asema miehiin nähden on paras syrjäseuduilla, joissa myös sukupuolten jakauma on vinoutunein miesten hyväksi ja jossa taloudellisia mahdollisuuksia on vähiten.
Naiset muodostavat yhä suuremman osan koulutetusta, urbaanista väestöstä, mutta suurituloisimmat ammatit näyttävät yhä olevan miesten hommia. Sen sijaan miehistyvällä maaseudulla vähät työpaikat jakautuvat tasaisemmin sukupuolten kesken, eikä kumpikaan sukupuoli saa suuria summia. Tutkitaan seuraavaksi miten valitut selittävät muuttujat korreloivat tuloerojen kanssa.
Korrelaatiomatriisi selittävistä muuttujista ja tuloerosta.
Korrelaatiomatriisista nähdään, että odotetusti selittävät muuttujat korreloivat melko voimakkaastikin keskenään, mikä tulee aiheuttamaan regressiomallissa kollineariteettiongelmia.
Miesten naisia suurempien tulojen kanssa korreloi voimakkaimmin yllä nähdyn kartan perusteella odotetusti kaikkien veronalaisten tulojen mediaani sekä väestön koulutustaso. Korkean tulotason ja koulutuksen sekä dynaamisen liike-elämän kunnissa myös sukupuolten väliset tuloerot venähtävät miesten hyväksi. Korkean työttömyyden ja heikon väestöllisen huoltosuhteen kunnissa taas naiset ovat suhteellisesti paremmin palkattuja. Ulkomaalaisten osuudella, muuttotaseella tai naisten työllisyysasteella ei näytä olevan juuri yhteyttä palkkatason eroon.
Kahden muuttujan välisten korrelaatioiden tarkastelu yksistään tarjoaa kuitenkin vääriä johtopäätöksiä jo mainittujen kollineariteettiongelmien vuoksi. Parempia johtopäätöksiä saadaan tehtyä, kun muiden selittävien muuttujien vaikutus palkkaeroon vakioidaan. Siksipä lopuksi mallinnan naisten ja miesten välistä palkkaeroa lineaarisen regression avulla. Skaalaan kaikki muuttujat yhteismitallisiksi, jotta muuttujien suhteellista selitysvoimaa ja tarkkuutta voidaan vertailla.
Ylläolevasta regressiotaulukosta nähdään, että malli on tilastollisesti merkitsevä ja selittää jopa 61 % miesten ja naisten alueellisessa palkkaerossa havaitusta vaihtelusta. Vakiotermi ei mallissa ole tilastollisesti merkitsevä, kuten ei myöskään väestön koulutustaso ja väestöllinen huoltosuhde. Nämä kaksi muuttujaa kuitenkin korreloivat vahvasti palkkaeron kanssa, mutta niiden korrelaatio myös muiden selittävien muuttujien kanssa vei niiden selitysvoiman kun työttömyysaste ja muut tekijät vakioitiin. Sen sijaan ulkomaalaisten osuus kunnan väestöstä esiintyykin voimakkaasti selitysvoimaisena muuttjana muiden selittävien muuttujien ollessa vakioitu. Muiden muuttujien ollessa vakioitu, korkeampi ulkomaalaisten osuus tarkoittaa naisille suhteellisesti parempaa palkkaa.
Myös muuttotase muuttuu tilastollisesti merkitseväksi selittäjäksi, kun muut selittävät muuttujat vakioidaan. Muuttovoittokunnissa naisten palkkaus vaikuttaisi olevan suhteellisesti parempaa. Kun muuttotasetta korreloitiin pelkän palkkaeron kanssa, vaikutussuhde oli päinvastainen. Muun ollessa vakiona myös naisten korkeampi työllisyysaste vaikuttaa voimakkaasti palkkaeroihin naisten kannalta suotuisasti. Tämä on hyvin looginen johtopäätös, joka ei selvinnyt korrelaatiomatriisista.
Liikevaihto suhteutettuna henkilöstöön, kaikkien veronalaisten tulojen mediaani, työttömyysaste sekä verovelvollisten lukumäärän logaritmi säilyttävät jo korrelaatiomatriisista nähdyt vaikutussuhteet. Kaiken muun ollessa vakiona miehet siis saavat suhteellisesti enemmän liksaa korkean tulotason, vähäisen työttömyyden ja ison väestöpohjan kunnissa, joiden yritykset takovat hyvää tulosta.
Yllä nähty malli toimii suhteellisen hyvin miesten ja naisten palkkaeron selittämisessä. Jäännöksiä tarkastellessa en havainnut mitään systemaattista virhettä ja mallilla korkea selitysaste. Mallin heikkous on sen muuttujien kollineariteettiongelmat, mutta käytettyäni Recursive Feature Elimination eli RFE-algoritmia valitsemaan optimaalisen selittävien muuttujien joukon, ei näiden perusteella tehty lopullinen malli poikennut juurikaan yllä nähdystä kaikki muuttujat sisältävästä mallista. Alla on vielä kuvaus ristiinvalidoinnin perusteella selitysvoimaisimmista muuttujista.
Järjestys oli nähtävissä jo regressiokertoimista.
Yllä olevasta tarkastelusta nähtiin, että miesten ja naisten palkkatuloissa on selkeitä alueellisia makrotason eroja. Tämä on suoraa seurausta erilaisten taloudellisten ekosysteemien ammattirakenteista sekä kuntien väestöpohjasta. Dynaamisissa, naisvoittoistuvissa kaupunkiyhteisöissä ja niiden lähikunnissa miehet tienaavat naisia paremmin, sillä niissä toistaiseksi "miehisillä" ammateilla pyyhkii hyvin ja miehet ovat perinteisesti olleet liike-elämän huipputehtävissä vahvemmin edustettuna. Miehistyvillä korkean työttömyyden syrjäseuduilla taas naiset pärjäävät paremmin, kun tarjontaa työpaikoista on vähemmän. Toisaalta muun ollessa vakioitu, naisten suhteellinen palkkataso paranee muuttovoittokunnissa, joissa naiset osallistuvat aktiivisemmin työelämään ja joissa on isompi maahanmuuttajapopulaatio.
Jos naisten ja miesten ansiotasoa halutaan aidosti kuroa umpeen, on lopetettava harhaanjohtava puhe "naisen euroista", joka luo mielikuvaa samassa työssä alhaisemmalla palkalla puurtavasta naisesta. Palkka on suhteellisen yksinkertaisesti mitattavissa oleva suure ja Milja Saaren sanoin "numeerisen kiistelyn" avulla voidaan saada informaatiota niistä seikoista, jotka aidosti aiheuttavat sukupuolten välillä havaittavaa eroa ansiotasossa. Ainoastaan validin faktaperustaisen tilastotieteellisen mallintamisen avulla voidaan kohdistaa huomio oikeisiin asioihin ja tehdä oikeita poliittisia päätöksiä.
Vanhemmuuden kulujen tasoittaminen on yksi helposti identifioitavissa oleva kehityskohde. Sukupuolittuneen ammattirakenteen purkaminen toinen. STTK: laisessa kielenkäytössä ymmärretty "palkkatasa-arvo", eli kahden sukupuolen yksilöiden palkkojen mediaanin täydellinen yhtäsuuruus riippumatta kaikista muista palkkaa selittävistä tekijöistä ei kuitenkaan ole maali, johon edes pitäisi pyrkiä.
Todellisuudessa miesten ja naisten saama palkkatulo samoista tehtävistä samanlaisella kokemuksella on lähes identtinen. Ei siis ole olemassa mitään 20 prosenttiyksikön mieslisää, jolla miehet tienaisivat samoista töistä enemmän kuin naiset. Sen sijaan sukupuolten välillä on eroja esimerkiksi ammattirakenteessa sekä tehdyissä työtunneissa, joiden vaikutukset saatuun palkkaan näyttäytyvät puusilmäisessä tarkastelussa sukupuolesta johtuvina palkkaeroina. Naisten ja miesten välinen ero ansiotuloissa on todellinen ja sisältää myös aitoja sukupuoli-perusteisia ongelmakohtia, joihin pitää puuttua. Mutta yksinkertaistamalla palkkaero binääriseksi kahden luokan väliseksi vertailuksi ilman muiden palkkaa selittävien muuttujien huomiointia kohdistuu huomio aivan vääriin asioihin.
Keskustelu palkkaerosta on siis usein aivan liian yksinkertaistettua eikä siinä huomioida mitään muuta kuin sukupuoli. Se on yhtä hedelmällistä kuin keskustella suomalaisten ja maahanmuuttajataustaisten rikollisuudesta käyttäen pelkästään etnisyyttä selittävänä tekijänä (maahanmuuttajat ovat esimerkiksi kantaväestöä nuorempia ja huono-osaisempia, mikä selittänee suuren osan havaituista eroista). Palkkaan vaikuttaa suuri määrä erilaisia muuttujia ja mikäli sukupuolten aitoa palkkaeroa halutaan tarkastella, tulee nämä taustatekijät ensiksi vakioida. Toisaalta jokainen tilastotiedettä vähänkin ymmärtävä tietää, että tarkasteluun valitut muuttujat muuttavat aina hieman tuloksia ja tehtäviä johtopäätöksiä, kuten Mika Malirantakin ansiokkaasti yllä linkkaamassani jutussa mainitsi. Siltikin mediassa paljon julkisuutta saaneen Milja Saaren väitöskirjassaan esittämä väite on huteralla pohjalla ja mielestäni suhteellisen heikko perusta tieteellisen tutkimuksen pohjaksi:
Aitoon keskusteluun palkkaeriarvoisuudesta, sen syistä, seurauksista ja samapalkkaisuuden toteuttamisen mahdollisuuksista on vaikea päästä, koska samapalkkaisuuskeskustelu tyrehtyy usein numeerisen kiistelyn tasolle: onko sukupuolten palkkaeroa olemassakaan, montako
prosenttia se on ja onko käytetty laskukaava tilastollisesti validi.
Mikrotasolla miesten ja naisten välistä palkkaeroa on tutkittu monen eri mallin voimin useaan kertaan, joista yksinkertaisin mallinnus on valitettavasti tunnetuin pelkän sukupuolen huomioiva"naisen euro"-päätelmä. Sen sijaan en ole aiemmin juuri törmännyt aiheen käsittelyyn rakenteellisella makrotasolla, jossa ihmisen asuinympäristö vaikuttaa myös sukupuolten väliseen tuloeroon. Tässä postauksessa tutkin miesten ja naisten palkkaeroa yksittäisten yksilöiden sijaan alueellisella makrotasolla; missä ja minkälaisissa kunnissa sukupuolten välinen ero palkkatuloissa on suurin?
Suomi on tunnetusti jakautunut voimakkaasti mies- ja naisaloihin ja ammatillinen segregaatio on EU:n kärkipäätä. Ammattijakauma on myös varsin poikkeava Suomen eri alueiden kesken, sillä esimerkiksi Kainuun perukoilla on huomattavasti vähemmän asiantuntijatehtäviä kuin suurissa kaupungeissa. Myös toimialarakenne tai esimerkiksi väestöllinen huoltosuhde ("vanhuskunnissa" tarvitaan enemmän naisvaltaisia hoitajia, joilla on yleisesti alhaiset palkat) ovat tekijöitä, jotka voivat makrotasolla johtaa suuriinkin kunnittaisiin eroihin eri sukupuolten ansiotasossa.
Aineistona minulla on Verohallinnon data päätoimen palkasta luontoisetuineen vuodelle 2014 (jaan vuoden kokonaispalkkatulot kahdellatoista, jotta saan approksimaation kuukausipalkasta) ja selittävinä muuttujina käytän logaritmia verovelvollisten määrästä (väestön määrän sijaan, logaritmi väestöjakauman vahvan vinouman vuoksi) sekä Tilastokeskukselta väestön koulutusmittaria (VKTM), työttömyystasoa, naisten työllisyysastetta, kuntien välistä muuttotasetta, väestöllistä huoltosuhdetta, ulkomaalaisten osuutta väestöstä sekä yritysten liikevaihtoa henkilöittäin.
Miesten ja naisten välinen tuloero kunnittain Suomessa 2014
Kun tuloerojen jakautumista tutkitaan alueittain niin huomataan, että hieman yllättäen tuloerot ovat suurimmat isoissa kaupungeissa ja niiden kehyskunnissa. Varsinkin Lapista löytyy toisaalta alueita, joissa naiset tienaavat miehiä paremmin. Kartan perusteella naisten suhteellinen asema miehiin nähden on paras syrjäseuduilla, joissa myös sukupuolten jakauma on vinoutunein miesten hyväksi ja jossa taloudellisia mahdollisuuksia on vähiten.
Naiset muodostavat yhä suuremman osan koulutetusta, urbaanista väestöstä, mutta suurituloisimmat ammatit näyttävät yhä olevan miesten hommia. Sen sijaan miehistyvällä maaseudulla vähät työpaikat jakautuvat tasaisemmin sukupuolten kesken, eikä kumpikaan sukupuoli saa suuria summia. Tutkitaan seuraavaksi miten valitut selittävät muuttujat korreloivat tuloerojen kanssa.
Korrelaatiomatriisi selittävistä muuttujista ja tuloerosta.
Korrelaatiomatriisista nähdään, että odotetusti selittävät muuttujat korreloivat melko voimakkaastikin keskenään, mikä tulee aiheuttamaan regressiomallissa kollineariteettiongelmia.
Miesten naisia suurempien tulojen kanssa korreloi voimakkaimmin yllä nähdyn kartan perusteella odotetusti kaikkien veronalaisten tulojen mediaani sekä väestön koulutustaso. Korkean tulotason ja koulutuksen sekä dynaamisen liike-elämän kunnissa myös sukupuolten väliset tuloerot venähtävät miesten hyväksi. Korkean työttömyyden ja heikon väestöllisen huoltosuhteen kunnissa taas naiset ovat suhteellisesti paremmin palkattuja. Ulkomaalaisten osuudella, muuttotaseella tai naisten työllisyysasteella ei näytä olevan juuri yhteyttä palkkatason eroon.
Kahden muuttujan välisten korrelaatioiden tarkastelu yksistään tarjoaa kuitenkin vääriä johtopäätöksiä jo mainittujen kollineariteettiongelmien vuoksi. Parempia johtopäätöksiä saadaan tehtyä, kun muiden selittävien muuttujien vaikutus palkkaeroon vakioidaan. Siksipä lopuksi mallinnan naisten ja miesten välistä palkkaeroa lineaarisen regression avulla. Skaalaan kaikki muuttujat yhteismitallisiksi, jotta muuttujien suhteellista selitysvoimaa ja tarkkuutta voidaan vertailla.
Residuals:
Min 1Q Median 3Q Max
-2.2624 -0.3517 0.0334 0.3055 3.9126
Coefficients:
Estimate Std. Error t value Pr(>|t|)
(Intercept) -7.749e-16 3.534e-02 0.000 1.00000
tyottomyysaste 1.090e+00 9.995e-02 10.909 < 2e-16 ***
muuttotase 1.253e-01 3.951e-02 3.172 0.00167 **
VKTM -7.548e-02 7.454e-02 -1.013 0.31203
tyollisyysasteNaiset 9.063e-01 9.124e-02 9.933 < 2e-16 ***
verovelvollisia -1.436e-01 5.765e-02 -2.491 0.01327 *
liikevaihtoperhenkilo -9.112e-02 4.152e-02 -2.194 0.02897 *
ulkomOsuus 2.296e-01 4.490e-02 5.113 5.62e-07 ***
huoltosuhde -4.618e-02 5.811e-02 -0.795 0.42747
tulotYht -4.330e-01 7.698e-02 -5.625 4.23e-08 ***
---
Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Residual standard error: 0.6253 on 303 degrees of freedom
Multiple R-squared: 0.6203, Adjusted R-squared: 0.609
F-statistic: 54.99 on 9 and 303 DF, p-value: < 2.2e-16
Ylläolevasta regressiotaulukosta nähdään, että malli on tilastollisesti merkitsevä ja selittää jopa 61 % miesten ja naisten alueellisessa palkkaerossa havaitusta vaihtelusta. Vakiotermi ei mallissa ole tilastollisesti merkitsevä, kuten ei myöskään väestön koulutustaso ja väestöllinen huoltosuhde. Nämä kaksi muuttujaa kuitenkin korreloivat vahvasti palkkaeron kanssa, mutta niiden korrelaatio myös muiden selittävien muuttujien kanssa vei niiden selitysvoiman kun työttömyysaste ja muut tekijät vakioitiin. Sen sijaan ulkomaalaisten osuus kunnan väestöstä esiintyykin voimakkaasti selitysvoimaisena muuttjana muiden selittävien muuttujien ollessa vakioitu. Muiden muuttujien ollessa vakioitu, korkeampi ulkomaalaisten osuus tarkoittaa naisille suhteellisesti parempaa palkkaa.
Myös muuttotase muuttuu tilastollisesti merkitseväksi selittäjäksi, kun muut selittävät muuttujat vakioidaan. Muuttovoittokunnissa naisten palkkaus vaikuttaisi olevan suhteellisesti parempaa. Kun muuttotasetta korreloitiin pelkän palkkaeron kanssa, vaikutussuhde oli päinvastainen. Muun ollessa vakiona myös naisten korkeampi työllisyysaste vaikuttaa voimakkaasti palkkaeroihin naisten kannalta suotuisasti. Tämä on hyvin looginen johtopäätös, joka ei selvinnyt korrelaatiomatriisista.
Liikevaihto suhteutettuna henkilöstöön, kaikkien veronalaisten tulojen mediaani, työttömyysaste sekä verovelvollisten lukumäärän logaritmi säilyttävät jo korrelaatiomatriisista nähdyt vaikutussuhteet. Kaiken muun ollessa vakiona miehet siis saavat suhteellisesti enemmän liksaa korkean tulotason, vähäisen työttömyyden ja ison väestöpohjan kunnissa, joiden yritykset takovat hyvää tulosta.
Yllä nähty malli toimii suhteellisen hyvin miesten ja naisten palkkaeron selittämisessä. Jäännöksiä tarkastellessa en havainnut mitään systemaattista virhettä ja mallilla korkea selitysaste. Mallin heikkous on sen muuttujien kollineariteettiongelmat, mutta käytettyäni Recursive Feature Elimination eli RFE-algoritmia valitsemaan optimaalisen selittävien muuttujien joukon, ei näiden perusteella tehty lopullinen malli poikennut juurikaan yllä nähdystä kaikki muuttujat sisältävästä mallista. Alla on vielä kuvaus ristiinvalidoinnin perusteella selitysvoimaisimmista muuttujista.
Yllä olevasta tarkastelusta nähtiin, että miesten ja naisten palkkatuloissa on selkeitä alueellisia makrotason eroja. Tämä on suoraa seurausta erilaisten taloudellisten ekosysteemien ammattirakenteista sekä kuntien väestöpohjasta. Dynaamisissa, naisvoittoistuvissa kaupunkiyhteisöissä ja niiden lähikunnissa miehet tienaavat naisia paremmin, sillä niissä toistaiseksi "miehisillä" ammateilla pyyhkii hyvin ja miehet ovat perinteisesti olleet liike-elämän huipputehtävissä vahvemmin edustettuna. Miehistyvillä korkean työttömyyden syrjäseuduilla taas naiset pärjäävät paremmin, kun tarjontaa työpaikoista on vähemmän. Toisaalta muun ollessa vakioitu, naisten suhteellinen palkkataso paranee muuttovoittokunnissa, joissa naiset osallistuvat aktiivisemmin työelämään ja joissa on isompi maahanmuuttajapopulaatio.
Jos naisten ja miesten ansiotasoa halutaan aidosti kuroa umpeen, on lopetettava harhaanjohtava puhe "naisen euroista", joka luo mielikuvaa samassa työssä alhaisemmalla palkalla puurtavasta naisesta. Palkka on suhteellisen yksinkertaisesti mitattavissa oleva suure ja Milja Saaren sanoin "numeerisen kiistelyn" avulla voidaan saada informaatiota niistä seikoista, jotka aidosti aiheuttavat sukupuolten välillä havaittavaa eroa ansiotasossa. Ainoastaan validin faktaperustaisen tilastotieteellisen mallintamisen avulla voidaan kohdistaa huomio oikeisiin asioihin ja tehdä oikeita poliittisia päätöksiä.
Vanhemmuuden kulujen tasoittaminen on yksi helposti identifioitavissa oleva kehityskohde. Sukupuolittuneen ammattirakenteen purkaminen toinen. STTK: laisessa kielenkäytössä ymmärretty "palkkatasa-arvo", eli kahden sukupuolen yksilöiden palkkojen mediaanin täydellinen yhtäsuuruus riippumatta kaikista muista palkkaa selittävistä tekijöistä ei kuitenkaan ole maali, johon edes pitäisi pyrkiä.
Tilaa:
Blogitekstit (Atom)